Эксперты в подборе IT-оборудования
Предиктивный мониторинг следит за тем, как метрика движется к порогу, и предупреждает заранее. Обычный мониторинг говорит «диск заполнен» в момент, когда он уже заполнен. Предиктивный говорит «этот раздел кончится через четверо суток» и оставляет вам выходные на подумать.
Магии тут нет и машинного обучения для начала тоже не нужно: основную работу делают прогнозные функции, которые уже есть в Zabbix и Prometheus. Ниже - что реально предсказывается, с каким запасом времени, и как это включить на том, что у вас уже стоит. Отдельно - список вещей, которые не предскажет никто, и на них лучше не рассчитывать. Всё это одинаково применимо и к парку из сотни машин, и к одному серверу в офис, который должен работать предсказуемо.
Обычный мониторинг смотрит на показатель изолированно: превысил порог - отправил алерт. Такой подход работает, но сообщает о проблеме тогда, когда пользователи уже её почувствовали.
Предиктивный смотрит на ту же метрику как на временной ряд: есть история, есть направление, есть скорость. Дальше простая арифметика: свободно 24 %, расход стабильно 8 % в неделю - значит, места хватит на три недели. Никакой нейросети для этого не нужно, нужна линейная экстраполяция и достаточная история наблюдений.
Самое ценное в предиктивном подходе вот что: несколько показателей, каждый в пределах нормы, вместе означают проблему.
Классический пример - диск на выходе. За пару недель до отказа растёт время отклика на чтение, появляются периодические всплески активности контроллера, медленно увеличивается число переназначенных секторов. По отдельности каждый показатель в норме и ни один порог не сработает. Вместе они складываются в понятную картину: диск сыпется.
Здесь же кроется ограничение. Чтобы система поймала такую связку, ей нужна история - минимум несколько недель нормальной работы, а лучше месяцы. На сервере, который поставили в прошлый вторник, предсказывать нечего.
Предиктивный мониторинг надстраивается над обычным и не отменяет его. Сначала должны работать пороги и алерты, и только потом поверх них имеет смысл строить прогноз.
Самая вредная идея вокруг темы - что предиктивная система избавит от аварий. Не избавит. Одни отказы имеют предысторию, другие происходят мгновенно, и честный разговор начинается с разделения этих двух групп.
| Событие | Предсказуемо? | На чём видно | Типичный запас времени |
|---|---|---|---|
| Отказ HDD | Часто | SMART: переназначенные секторы, ожидающие секторы, ошибки чтения | Дни, иногда недели |
| Исчерпание ресурса SSD/NVMe | Почти всегда | Показатель износа (Percentage Used у NVMe) | Месяцы |
| Заполнение раздела | Почти всегда | Тренд свободного места | Дни, недели |
| Утечка памяти в приложении | Часто | Рост потребления с «пилой» после перезапусков | Дни |
| Деградация батареи RAID-контроллера | Да | Состояние BBU, отключение кэша записи при проверке | Недели |
| Перегрев из-за пыли или деградации термоинтерфейса | Да | Рост температуры при неизменной нагрузке | Недели, месяцы |
| Износ вентиляторов | Да | Падение оборотов, рост разброса между вентиляторами | Недели |
| Истечение сертификатов и лицензий | Тривиально | Дата в самом сертификате | Сколько угодно |
| Внезапная смерть блока питания | Нет | - | - |
| Kernel panic, баг в обновлении | Нет | - | - |
| Ошибка человека, случайное удаление данных | Нет | - | - |
| Отказ после скачка напряжения | Нет | - | - |
Про диски есть честная цифра. Backblaze, которая публикует статистику по десяткам тысяч накопителей, отслеживает пять SMART-атрибутов: 5 (переназначенные секторы), 187 (неисправимые ошибки), 188 (таймаут команды), 197 (ожидающие секторы) и 198 (неисправимые при офлайн-проверке). По их данным 76,7 % отказавших дисков заранее показывали ненулевое значение хотя бы по одному из этих пяти.
Цифру стоит прочитать в обе стороны. Три четверти дисков предупреждают о смерти - это много и это работает. Но почти каждый четвёртый умирает молча, без единого тревожного атрибута. Поэтому предиктивный мониторинг дисков не отменяет ни RAID, ни резервные копии, и любой, кто утверждает обратное, продаёт вам что-то лишнее.
С памятью похожая история, только мутнее. Исправляемые ошибки ECC - сигнал, что с планкой что-то не так, и заметная часть модулей с неисправимыми ошибками до этого показывала исправляемые. Но связь не жёсткая: планка может годами работать с редкими исправляемыми ошибками и не выйти из строя. Разумная реакция: следить за частотой ошибок и планировать замену, если она растёт. Паниковать после первой - рано.
Расшифровка конкретных SMART-атрибутов - тема отдельная и подробная, она у нас разобрана в статье про показатели SMART на серверных дисках. А если тревожный атрибут уже загорелся и надо разобраться прямо на работающей машине - это диагностика диска без остановки сервера.
Не всякая метрика годится для прогноза. Мгновенная загрузка процессора почти бесполезна: она скачет и ничего не предвещает. Ценность имеют показатели, у которых есть медленный тренд.
Пики тут мало что говорят. Смотреть стоит на медленный рост базовой загрузки при неизменном профиле работы. Это типичный признак того, что приложение течёт или база данных обросла данными и запросы стали тяжелее. Полезны также время ожидания ввода-вывода и частота переключений контекста.
Главное - форма графика. Утечка выглядит как ровный рост с обрывом вниз после каждого перезапуска сервиса: «пила» с наклоном. Одного взгляда на недельный график обычно достаточно, чтобы отличить утечку от честного роста нагрузки. Отдельно следите за появлением обращений к swap там, где раньше их не было.
Свободное место - самая простая и самая окупаемая метрика для прогноза, потому что растёт предсказуемо. Здоровье накопителей - через SMART для дисков и показатель износа для SSD: Percentage Used у NVMe идёт от нуля к сотне и работает как индикатор остатка ресурса.
Ключевое слово - «при неизменной нагрузке». Рост температуры сам по себе не значит ничего, сервер под нагрузкой греется. А вот та же нагрузка при температуре на пять градусов выше, чем месяц назад, - это либо пыль, либо высохший термоинтерфейс, либо вентилятор, который уже не тянет.
Медленная деградация ответа заметна раньше, чем начнутся ошибки, и часто предшествует им. Как это измерять - в разборе про APM и время отклика приложения.
Здесь начинается практика. Разворачивать платформу с машинным обучением ради пятнадцати серверов не нужно - нужные функции есть в системах, которые у вас, скорее всего, уже работают.
В Zabbix прогнозные функции живут с версии 3.0, и их две.
timeleft() отвечает на вопрос «сколько секунд осталось до того, как метрика упрётся в заданное значение». Чаще всего его вешают на свободное место: триггер настраивается так, чтобы сработать, если по текущему тренду раздел кончится, скажем, менее чем через неделю. Вы получаете предупреждение заранее и в рабочее время, а не в три ночи, когда место закончилось.
forecast() отвечает на обратный вопрос: какое значение метрика примет через заданное время. Годится, когда важен не момент упора в потолок, а сама величина: каким будет потребление памяти к концу недели.
У обеих функций настраивается тип аппроксимации. По умолчанию линейная, и для большинства задач её хватает; полиномиальная и экспоненциальная нужны редко и требуют понимания, как ведёт себя ваша метрика. Начинайте с линейной.
Про установку и базовую настройку самого Zabbix у нас есть отдельная статья: мониторинг серверов на Zabbix.
В Prometheus ту же задачу решает predict_linear(). Он строит линейную регрессию по указанному окну и говорит, каким будет значение через заданное время. Канонический пример - предсказание заполнения диска: берётся свободное место за последние полчаса и проверяется, не уйдёт ли оно в минус в ближайшие два часа. Если да - алерт.
Окно наблюдения важнее, чем кажется. Слишком короткое даст ложные срабатывания на любом всплеске записи, слишком длинное не заметит, что скорость расхода изменилась вчера. Для дисков обычно берут от получаса до нескольких часов, дальше подбирают по своим данным.
Развёртывание связки описано в статье про сбор и визуализацию метрик в Prometheus и Grafana.
Тогда предиктивный мониторинг - не ваша сегодняшняя задача. Сначала нужен обычный: сбор метрик, хранение истории, работающие пороги и алерты, которые доходят до человека. История наблюдений - сырьё для любого прогноза, и без неё предсказывать не из чего. С чего начать - в разборе про комплексный мониторинг серверов.
Технически прогноз надстраивается над обычным мониторингом и добавляет к нему две вещи: достаточно длинную историю и слой, который её считает.
Сбор. Агенты на серверах, интервал опроса 10-30 секунд для большинства метрик. Чаще нужно редко и дорого обходится по объёму данных.
Хранение. Ключевой момент, на котором всё обычно и спотыкается: для прогноза нужна история, а её по умолчанию хранят недолго. Прежде чем строить предсказания, проверьте, сколько недель метрик у вас реально лежит. Специализированные базы временных рядов хранят такие данные компактнее обычных реляционных и быстрее отвечают на запросы по диапазонам дат.
Расчёт. Для начала это встроенные функции Zabbix или Prometheus. Отдельный аналитический слой с обучаемыми моделями оправдан, когда серверов сотни и есть кому этим заниматься. Для парка в два десятка машин овчинка выделки не стоит.
Начинать стоит с ревизии, а не с закупки. Довольно часто оказывается, что метрики уже собираются несколько месяцев, просто никто не смотрел на них как на историю для прогноза.
Одна система, где простой дорого стоит и где есть накопленные данные. Файловое хранилище или сервер базы данных подходят лучше всего: у них понятные метрики с ровными трендами.
Самый благодарный первый шаг: тренд ровный, ложных срабатываний мало, польза видна сразу. Получилось - переходите к памяти и температурам.
Предиктивное предупреждение отличается от обычного тем, что оно не требует немедленных действий - оно требует запланировать работу. Если по такому алерту никто не заводит задачу, система бесполезна, как бы точно она ни предсказывала. Платформы класса AIOps умеют идти дальше и сами заводить заявку или переносить нагрузку, но это история для больших инфраструктур с зрелыми процессами.
Лучше начать с грубых настроек и пропустить пару событий, чем с первого дня завалить дежурного ложными тревогами. Доверие к системе теряется быстро и восстанавливается долго.
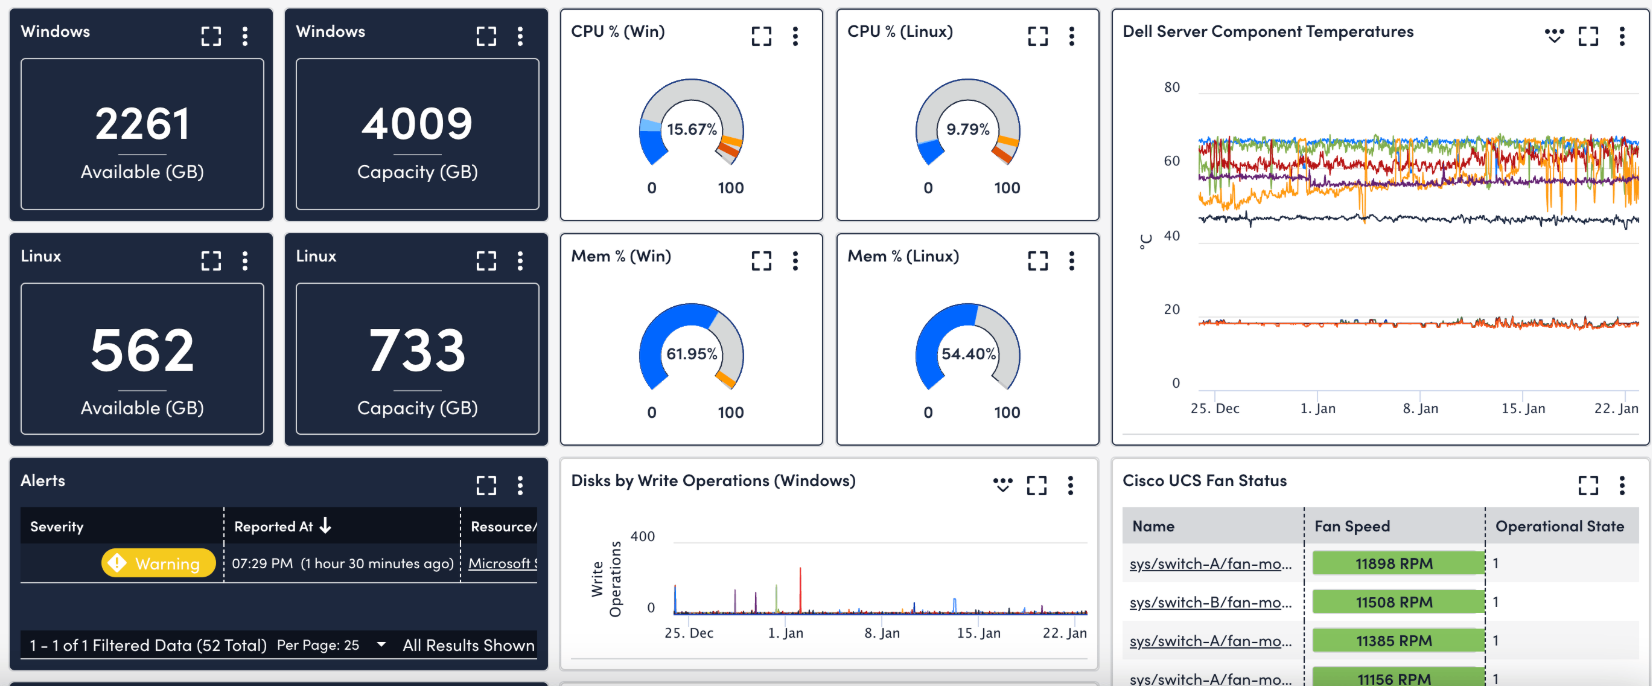
Ложные срабатывания. Главная угроза для всей затеи. Прогноз по своей природе иногда ошибается, и если предупреждений слишком много, их перестают читать - вместе с настоящими. Лечится это настройкой чувствительности и дисциплиной в оповещениях: правильная группировка, разумные интервалы повторов, разделение по важности. Тема большая, разобрана отдельно в статье про настройку алертинга без лишних срабатываний.
Качество данных. Пропуски в метриках, разъехавшееся время на серверах, выбросы после перезагрузок - всё это ломает любой прогноз. Синхронизация времени по NTP на всём парке - не гигиена ради гигиены, а условие, без которого сравнивать метрики между машинами бессмысленно.
Прогноз устаревает. Настройки, подобранные под прошлогоднюю нагрузку, на новой начинают врать. Переехали на другое железо, добавили сервисов, изменился профиль работы - пороги и окна надо пересматривать. Раз в полгода достаточно.
Непонятно, почему система так решила. Чем сложнее модель, тем труднее объяснить её вывод, и тем меньше ей доверяют. Это ещё один довод в пользу того, чтобы начинать с простой экстраполяции: у неё вывод проверяется глазами по графику за минуту.
Формальные метрики качества прогноза существуют - доля сбывшихся предсказаний, доля пойманных отказов и сводный показатель между ними. Считать их имеет смысл, когда система работает давно и событий накопилось достаточно для статистики.
Для небольшой инфраструктуры полезнее две вещи.
Время упреждения. Насколько заранее пришло предупреждение и хватило ли этого, чтобы спокойно всё сделать. Предупреждение за час до заполнения диска технически верное, а практически бесполезное.
Сколько аварийных работ стало плановыми. Это то, ради чего всё затевалось. Замена диска в среду днём по заявке и замена того же диска в субботу ночью по звонку - разные по стоимости события, хотя диск один и тот же.
Это мониторинг, который смотрит на историю метрики и предупреждает о проблеме до того, как она случится. Обычный сообщает, что диск заполнен. Предиктивный - что он заполнится через четыре дня.
Для начала нет. Основную пользу дают встроенные прогнозные функции Zabbix и Prometheus, работающие на линейной экстраполяции. Обучаемые модели оправданы на больших парках, где есть кому их сопровождать.
Со свободного места на дисках. Тренд ровный, прогноз надёжный, ложных срабатываний мало, а польза видна сразу.
Для простых трендов вроде заполнения диска хватает пары недель. Для метрик с недельной цикличностью - несколько месяцев, иначе система будет принимать понедельник за аномалию.
Нет. Примерно каждый четвёртый диск отказывает без предупреждающих признаков в SMART, а часть отказов не предсказуема в принципе. Прогноз сокращает число аварий, но не отменяет ни резервных копий, ни отказоустойчивости.
Да, если мониторинг уже налажен и метрики хранятся хотя бы несколько недель. Начать стоит с прогноза свободного места и контроля SMART - это настраивается за вечер и не требует ни новых лицензий, ни отдельного специалиста.
Подбираем и поставляем серверы под задачу.
Если по итогам мониторинга видно, что железо подошло к концу ресурса, поможем посчитать замену: подберём конфигурацию под вашу нагрузку, соберём и протестируем перед отгрузкой.
Смотрите каталог серверов или напишите нам - разберёмся вместе.
Телефон: 8 800 551-80-12. Почта: info@ittelo.ru. На рынке серверов 11+ лет.