Эксперты в подборе IT-оборудования
Сотня виртуальных машин, терабайты бэкапов и счёт за хранение, который растёт быстрее бюджета отдела. Знакомая арифметика. При этом изрядная часть того, что лежит на дисках, - копии одного и того же: одинаковые образы ОС на виртуалках, повторяющиеся библиотеки, документы, сохранённые в десяти местах «на всякий случай». Дедупликация и сжатие существуют ровно затем, чтобы за эти копии не платить дважды.
Насколько именно не платить - зависит от данных. Microsoft приводит по своей дедупликации такие цифры экономии: документы 30-50 %, общая файловая шара 50-60 %, дистрибутивы и двоичные файлы 70-80 %, библиотеки ISO-образов и виртуальных дисков 80-95 %. Разброс между документами и библиотекой образов - в разы, и это первое, что стоит держать в голове, глядя на вендорские обещания.
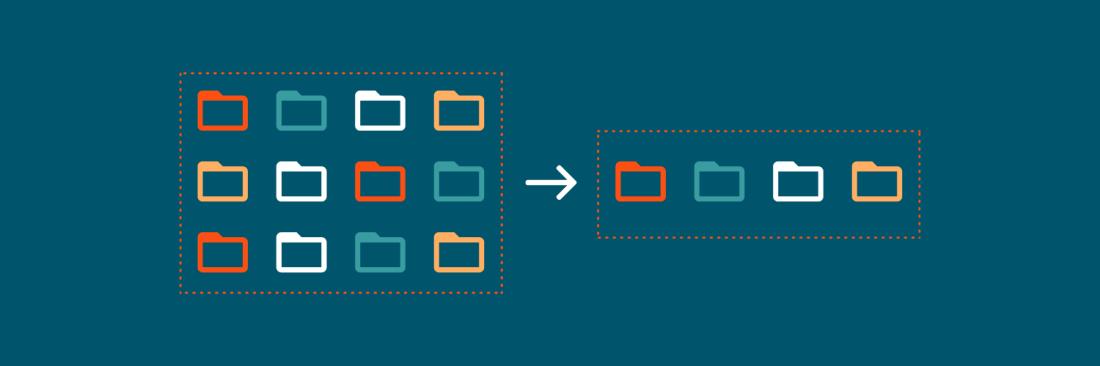
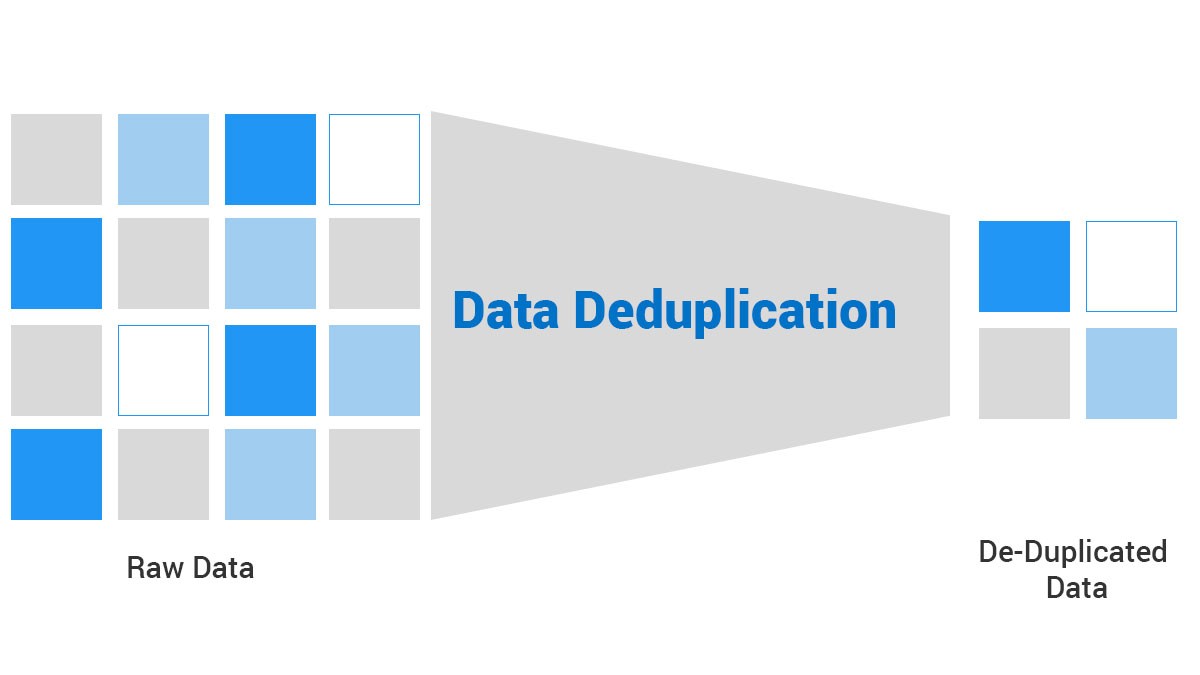
Дедупликация находит одинаковые данные и оставляет один экземпляр, заменяя остальные копии ссылками на него.
Работает это так. Система разбивает поступающие данные на блоки, считает для каждого блока хеш - короткую контрольную сумму фиксированной длины - и сверяется с индексом: встречался ли такой блок раньше. Встречался - вместо записи копии система ставит ссылку на уже лежащий блок и увеличивает счётчик ссылок. Не встречался - блок записывается, а его хеш попадает в индекс.
Глубина обработки бывает разной. Файловая дедупликация сравнивает файлы целиком: нашла два полностью идентичных - оставила один. Просто и дёшево, но в реальной жизни малорезультативно. Отредактировали в документе одну букву - для системы это уже два разных файла, и экономии нет.
Блочная дедупликация работает на уровне блоков внутри файлов. Изменили одну страницу в стостраничном документе - на диск ляжет только изменившийся блок, остальные останутся в единственном экземпляре. Именно блочная дедупликация стоит практически во всех промышленных СХД и системах резервного копирования; файловая осталась нишевым инструментом.
Блоки бывают фиксированного и переменного размера, и выбор между ними - всегда компромисс.
Фиксированные блоки - это как нарезать батон ровными кусками: система режет поток данных на куски по 4, 8 или 16 килобайт независимо от содержимого. Быстро и предсказуемо. Но если данные сдвинулись хотя бы на байт - скажем, в начало файла добавили символ, - все границы «поедут», и система не узнает в новых блоках старые.
Переменные блоки эту проблему решают. Алгоритм ищет границы по самому содержимому, применяя скользящее окно: считает хеш по движущемуся участку данных и ставит границу блока там, где значение попадает в заданный шаблон. Данные сместились - границы сместились вместе с ними, и повторы находятся по-прежнему.
| Критерий | Фиксированный блок | Переменный блок |
|---|---|---|
| Нагрузка на процессор | Минимальная | Заметно выше |
| Объём метаданных | Предсказуемый | Больше |
| Устойчивость к сдвигу данных | Нет: границы «едут» | Есть: границы ищутся по содержимому |
| Эффективность на образах ВМ | Хорошая | Хорошая |
| Эффективность на неструктурированных данных | Слабая | Заметно выше |
| Где обычно применяют | Массивы, блочный доступ, all-flash | Софт резервного копирования, дедуплицирующие хранилища |
Отсюда и разделение на практике: массивы, где важна задержка, чаще идут по фиксированному блоку, а системы резервного копирования, где считают экономию за годы хранения, - по переменному.
Вторая развилка - момент обработки.
Inline-дедупликация происходит в момент записи: данные приходят, хешируются, сверяются с индексом и только потом попадают на диск. Место экономится сразу, лишнего пространства под «сырые» данные не нужно. Плата - задержка на запись и постоянная нагрузка на контроллер.
Post-process работает наоборот: данные пишутся как есть, а дубликаты вычищаются позже, фоновым заданием. Запись не тормозит, но на томе постоянно нужен запас под ещё не обработанные данные, и в момент прохода задания система заметно нагружена.
| Критерий | Inline | Post-process |
|---|---|---|
| Задержка при записи | Растёт | Не меняется |
| Запас места под необработанные данные | Не нужен | Нужен, иногда значительный |
| Когда виден эффект | Сразу | После прохода задания |
| Пиковая нагрузка | Размазана по записи | Собрана в окно обслуживания |
| Типичный сценарий | All-flash массивы, дедуплицирующие хранилища бэкапов | Файловые серверы, тома с окном обслуживания |
Многие массивы умеют оба режима и разводят их по пулам: под бэкапы и архивы включают inline, под нагрузку, чувствительную к задержке, оставляют post-process или не включают дедупликацию вовсе.
Дедупликация убирает повторы между блоками. Со всем, что осталось уникальным, работает сжатие - оно ужимает данные внутри блока.
Порядок операций почти всегда такой: сначала дедупликация, потом сжатие. Смысл простой - незачем тратить процессор на сжатие блока, который сейчас окажется дубликатом и будет выброшен.
| Алгоритм | Скорость | Степень сжатия | Где обычно ставят |
|---|---|---|---|
| LZ4 | Очень высокая | Умеренная | Значение по умолчанию там, где важна задержка |
| Zstd | Высокая, уровень настраивается | Заметно выше LZ4 | Универсальный выбор последних лет |
| gzip / deflate | Низкая | Высокая | Архивы и холодные данные |
Zstd за последние годы стал самым ходовым выбором: у него настраиваемый уровень, так что одним алгоритмом закрывается и быстрый режим, и режим плотной упаковки.
Чего сжатие не сделает - так это не ужмёт то, что уже сжато. Видео, фотографии в JPEG, музыка, ZIP-архивы, зашифрованные тома: там энтропия близка к максимуму, и процессор просто отработает вхолостую. На таких пулах компрессию отключают осознанно.
Один и тот же результат можно получить в трёх разных местах инфраструктуры, и стоят они по-разному.
| Где | Чем платим | Что получаем |
|---|---|---|
| На сервере, силами ОС или файловой системы (ZFS, дедупликация Windows Server) | Процессор и память самого сервера | Ничего не надо покупать, работает на любом железе |
| В массиве, на контроллере СХД | Лицензия, привязка к вендору | Хост не нагружается вовсе, обработка ближе к дискам |
| В софте резервного копирования, на стороне агента | Ресурсы защищаемой машины | Дубликаты отсеиваются до передачи - экономится и канал, и диск |
Третий вариант часто недооценивают, а он решает отдельную задачу. Если бэкап уезжает на удалённую площадку по узкому каналу, дедупликация на стороне источника сокращает объём трафика, а не место в хранилище, - и именно это определяет, уложится ли резервное копирование в ночное окно.
Где именно в массиве выполняется расчёт хешей, зависит от архитектуры: в одних системах этим занимаются контроллеры, в других - отдельные модули аппаратного ускорения. Что стоит внутри и как распределяются роли, мы разбирали в материале про устройство СХД: контроллеры, полки и внутреннюю архитектуру.
И отдельно, чтобы не путать понятия: дедупликация оперативной памяти - это другая технология. Гипервизор ищет одинаковые страницы памяти у виртуальных машин и оставляет одну физическую копию на всех (в Linux и KVM этот механизм называется KSM, у VMware исторически - Transparent Page Sharing). К дедупликации данных на дисках она отношения не имеет, экономит другой ресурс и настраивается в другом месте.
Виртуализированные среды - самая благодарная площадка для дедупликации. Сто виртуальных машин с одной и той же гостевой ОС, одинаковыми системными библиотеками и часто одинаковым прикладным ПО. Без дедупликации на дисках лежит сто копий системы, с дедупликацией - одна плюс уникальные данные каждой машины.
VMware vSAN, Nutanix, HPE SimpliVity встроили дедупликацию прямо в архитектуру - правда, у vSAN она доступна только в all-flash конфигурациях, и это стоит проверить до закупки дисков. Выигрыш тут шире, чем экономия места: меньше данных - быстрее репликация между площадками, короче окно бэкапа, меньше трафика при миграции машин.
Есть и цена. Все эти виртуалки теперь опираются на одни и те же физические блоки. Повредился блок с системной библиотекой - пострадают все машины, которые на него ссылаются. Поэтому дедуплицированные данные требуют внимания к избыточности: критичные блоки в промышленных системах хранятся в нескольких копиях даже после дедупликации, и экономия на этом месте оборачивается очень дорого.
Если на виртуализации дедупликация окупается, то на бэкапах она окупается многократно. Полный бэкап сервера раз в неделю, между копиями меняется 5-10 % данных. Без дедупликации каждая копия - полный объём. С дедупликацией на диск ложатся только изменившиеся блоки.
Veeam, Commvault, Cohesity NetBackup (до перехода продукта к Cohesity он был известен как Veritas NetBackup) используют дедупликацию как базовую функцию. Коэффициенты 20:1 и выше для долгосрочных архивов - обычное дело.
Только читать такие цифры надо с оговоркой. Коэффициент 20:1 получается на длинной цепочке полных копий одних и тех же данных - то есть ровно там, где повторов заведомо много. На смешанном пуле с уникальными пользовательскими файлами тот же продукт покажет 2:1 или 3:1, и это нормально. Вендорская цифра из презентации - это верхняя граница на удобном наборе данных, а не обещание для вашей инфраструктуры.
Дедупликация ищет повторы и между разными машинами, а не в границах одной. Если один файл лежит на десяти серверах, в общем дедуплицированном хранилище он займёт место один раз. Это называется глобальной дедупликацией. Как под такие сценарии подбирают само хранилище, разбирали отдельно - резервное копирование на СХД.
Про экономию пишут все, про обратную операцию - почти никто. А она и определяет, насколько быстро вы восстановитесь.
Регидрация (её же называют раздедупликацией) - это сборка исходных данных из дедуплицированного вида. Когда приложение читает файл, система идёт по ссылкам, собирает блоки из разных мест хранилища и отдаёт их в исходном порядке.
Отсюда главное следствие: чтение с дедуплицированного хранилища устроено тяжелее, чем запись на него. Файл, который лежал бы одним последовательным куском, физически разбросан по тому, и последовательное чтение превращается в набор случайных обращений. На SSD разница умеренная, на HDD - принципиальная: механика упирается в число операций в секунду, а не в мегабайты.
Практический вывод для резервного копирования: коэффициент дедупликации улучшает срок хранения, но не улучшает время восстановления - скорее наоборот. Прикидывая RTO, ориентируйтесь не на скорость записи бэкапа, а на реальную скорость чтения с дедуплицированного хранилища. Проверять это надо тестовым восстановлением, а не расчётом.
Отдельная история - раздедупликация тома целиком, когда функцию решили выключить. Данные придётся развернуть обратно, и им нужно физическое место. Если том заполнен под завязку, операция просто не пройдёт: разворачивать некуда. Поэтому включение дедупликации на почти полном томе - решение, из которого потом трудно выйти.
У технологии есть цена, и в брошюрах её печатают мелким шрифтом.
Процессор. Хеширование каждого блока при записи - постоянная нагрузка. На системах с большим потоком случайных операций ввода-вывода inline-дедупликация становится узким местом.
Память. Чтобы работать быстро, система держит индекс блоков в оперативной памяти. Уедет индекс на диск - производительность падает в разы. Порядок величин удобно смотреть на двух системах с публичными нормами:
| Система | Норма памяти | Что это значит на практике |
|---|---|---|
| Дедупликация Windows Server | Минимум 300 МБ + 50 МБ на 1 ТБ логических данных; комфортно около 1 ГБ на 1 ТБ | На томе 10 ТБ - 800 МБ по минимуму и порядка 10 ГБ, чтобы работало без сюрпризов |
| ZFS, классическая дедупликация | Около 320 байт на блок в таблице DDT; ходовой ориентир - от 1 до 5 ГБ на 1 ТБ в зависимости от размера записи | Таблица не должна занимать больше четверти ARC, иначе кеш перестаёт справляться со своей основной работой |
Коллизии хешей. Вероятность того, что два разных блока дадут одинаковый хеш, ничтожна: для SHA-256 пространство значений - порядка 10 в 77-й степени. Ничтожна, но не равна нулю, поэтому системы, где цена ошибки высока, дополнительно сверяют блоки с совпавшими хешами побайтово. Режим стоит производительности и потому включается не всегда - если данные критичны, спрашивайте у вендора, что стоит по умолчанию.
Программная дедупликация живёт на уровне операционной системы или файловой системы. ZFS и дедупликация Windows Server - самые распространённые примеры. Гибко, дёшево на входе, работает на любом железе; расплата - процессор и память сервера. Как это выглядит на практике в Windows, разбирали в отдельном материале: дедупликация данных в Windows Server.
Аппаратная выполняется в самой системе хранения - контроллерами или специализированными модулями. HPE StoreOnce, Dell PowerProtect Data Domain (прежнее имя линейки, Data Domain, до сих пор в ходу) - классические представители. Производительность выше, сервер не нагружается совсем, но растёт стоимость и появляется привязка к экосистеме вендора. Что даёт каждый подход по цифрам, мы измеряли: сравнение программной и аппаратной СХД с тестированием скорости.
Отдельно про российские системы, потому что в статьях на эту тему их обычно нет вовсе. Картина неоднородная, и по бренду судить нельзя. У Аэродиска в линейке ENGINE AQ заявлены онлайн-дедупликация с фиксированным блоком и онлайн-компрессия. А у YADRO в описании TATLIN.UNIFIED набор функций другой - T-RAID, erasure coding, мгновенные снимки, синхронная репликация, симметричный active-active; дедупликации и компрессии в этом перечне нет.
Самое заметное событие последних лет - Fast Dedup в OpenZFS 2.3 (январь 2025). Классическая дедупликация ZFS имела дурную репутацию заслуженно: таблица DDT писалась вразнобой по мере поступления записей, это раздувало объём записи и било по производительности, и рекомендация звучала однозначно - «в продакшене не включать».
Fast Dedup, разработанный в iXsystems и переданный проекту OpenZFS, переписал механику: записи DDT сначала попадают в журнал и только потом, отсортированными, сбрасываются в саму таблицу. Добавились предвыборка, прунинг устаревших записей и квота на размер таблицы - то есть теперь есть штатный способ не дать индексу разрастись бесконтрольно. Дедупликация в ZFS перестала быть заведомо плохой идеей, хотя память по-прежнему считать надо.
Вторая перемена - переход на флеш. На all-flash массивах inline-дедупликация перестала быть компромиссом: накопители отрабатывают случайные обращения так быстро, что и хеширование при записи, и разбросанные по тому блоки при чтении перестают быть заметными на фоне общей задержки. Почему all-NVMe массивы становятся стандартом корпоративного хранения, мы разбирали отдельно - дедупликация здесь одна из причин, а не следствие.
Наконец, persistent memory хорошо ложится под индексы дедупликации: скорость близка к оперативной памяти, а содержимое переживает перезагрузку - то есть после рестарта не нужно заново прогревать таблицу.
Дальше всё упирается в то, какие у вас данные. Ориентир по типам:
| Данные | Чего ждать от дедупликации | Включать? |
|---|---|---|
| Образы виртуальных машин, библиотеки ISO | Очень высокая экономия, повторов много по определению | Да |
| Цепочки резервных копий | Высокая экономия, растёт с глубиной хранения | Да |
| Дистрибутивы, двоичные файлы | Высокая экономия | Да |
| Общие файловые шары, документы | Умеренная экономия | Обычно да |
| Базы под OLTP-нагрузкой | Экономия небольшая, задержка растёт | Скорее нет |
| Медиафайлы, фотоархивы, готовые архивы | Почти ничего: данные уже сжаты | Нет |
| Зашифрованные тома | Ничего: шифротекст неповторим по построению | Нет |
Последняя строка стоит отдельного слова, потому что о неё регулярно спотыкаются. Если данные шифруются до того, как попадут в хранилище, дедуплицировать там нечего: два одинаковых исходных блока после шифрования дадут разный шифротекст. Порядок «сначала дедупликация и сжатие, потом шифрование» здесь обязателен: иначе обе функции работать просто не будут.
С базами данных всё зависит от профиля. OLAP с редкими, но объёмными загрузками дедупликация может ощутимо ужать. OLTP с постоянным потоком мелких транзакций - редко: экономия скромная, а задержка на запись и разбросанные при чтении блоки бьют по тому, ради чего эту базу и держат.
Прикинуть экономию можно и не включая функцию. У Microsoft для этого есть отдельная утилита DDPEval.exe: она проходит по указанному каталогу (в том числе по сетевой шаре) и показывает, сколько бы освободилось. Для оценки массива это, конечно, не замена пилоту на реальных данных, но по файловым шарам даёт быстрый и честный порядок цифр.
Разумный компромисс - селективная дедупликация: включить её на пулах с архивами и бэкапами и не включать на горячих базах. Такой режим поддерживает большинство промышленных массивов, и по умолчанию имеет смысл идти именно этим путём, а не переводить систему в один режим целиком.
Дедупликация и сжатие давно перестали быть отдельной опцией: в промышленных системах хранения это базовая функциональность. Но включать её везде подряд только потому, что она есть, - плохая стратегия. Работает простое правило: посмотрите на свои данные, прикиньте память под индекс, проверьте скорость восстановления, а не одной лишь записи, - и включайте там, где арифметика сходится.
Подбираете систему хранения и считаете, во что обойдётся ёмкость?
Инженеры ITTELO помогут рассчитать полезную ёмкость под ваш профиль данных - с учётом дедупликации, компрессии и запаса под рост, - подберут конфигурацию, соберут и протестируют её под задачу перед отгрузкой, с гарантией и поддержкой после продажи. На рынке серверов 11+ лет.
Системы хранения данных · +7 (800) 551-80-12 · info@ittelo.ru