Эксперты в подборе IT-оборудования
Репликация данных - это непрерывное копирование изменений с одной системы хранения или базы данных на другую. Вторая копия всё время держится в актуальном состоянии и готова принять работу, если первая откажет.
Почему интернет-магазин продолжает принимать заказы, когда у него сгорел массив в серверной? Потому что те же данные уже лежали на втором массиве - в соседней комнате или в другом конце города. Копировать можно на трёх уровнях: сама СХД передаёт блоки томов, сервер или гипервизор реплицирует диски и виртуальные машины, приложение (обычно СУБД) пересылает свои изменения. Принципы у всех трёх общие, различаются цена и ограничения. Ниже сначала про общие принципы, потом про репликацию между СХД, а в конце - что делать, если второго массива нет и не будет.
Многие путают эти понятия, и ошибка дорого обходится при проектировании инфраструктуры. Резервная копия - страховка на случай катастрофы: данные восстанавливаются на момент последнего бэкапа, всё после него теряется. Репликация создаёт живую копию, которая подхватывает нагрузку при сбое основной системы за минуты, а в метрокластере - вообще без остановки.
Представьте интернет-магазин в «черную пятницу». Если основная база упадёт, переключение на реплику займёт от секунд до минут, покупатели могут даже не заметить. С резервной копией вы потеряете заказы за последние часы и проведёте ночь, восстанавливая систему.
У репликации есть обратная сторона: она старательно копирует и ошибки. Удалили таблицу, зашифровал вирус, скрипт затёр каталог - через миллисекунды (в синхронном режиме) то же самое будет на реплике. От сбоя железа и площадки репликация спасает, от человека и шифровальщика - нет. Бэкап с историей нужен всё равно.
СХД реплицирует тома (LUN) целиком, на уровне блоков. Массив-источник перехватывает каждую запись в том и отправляет её на парный том второго массива. Сервер, который пишет в том, об этом не знает: для него это обычный диск. Отсюда главный плюс - репликация работает для любой ОС, гипервизора и СУБД, ресурсы серверов на копирование не тратятся.
Минус тоже понятен. Массивы в паре почти всегда должны быть одного производителя, а часто и одной линейки: протокол репликации у каждого вендора свой. Купить «какой-нибудь второй массив подешевле» для реплики обычно не выйдет.
Если приложение хранит данные на нескольких томах (база на одном, журналы транзакций на другом), тома объединяют в группу согласованности. Массив копирует их как единое целое, в одном порядке записей. Без этого на реплике база может оказаться в состоянии, которого никогда не было на источнике, и не поднимется.
Физически массивы соединяют тремя способами:
Про сами протоколы подробнее в статье про протоколы доступа к данным в СХД: iSCSI, Fibre Channel, NFS и SMB.
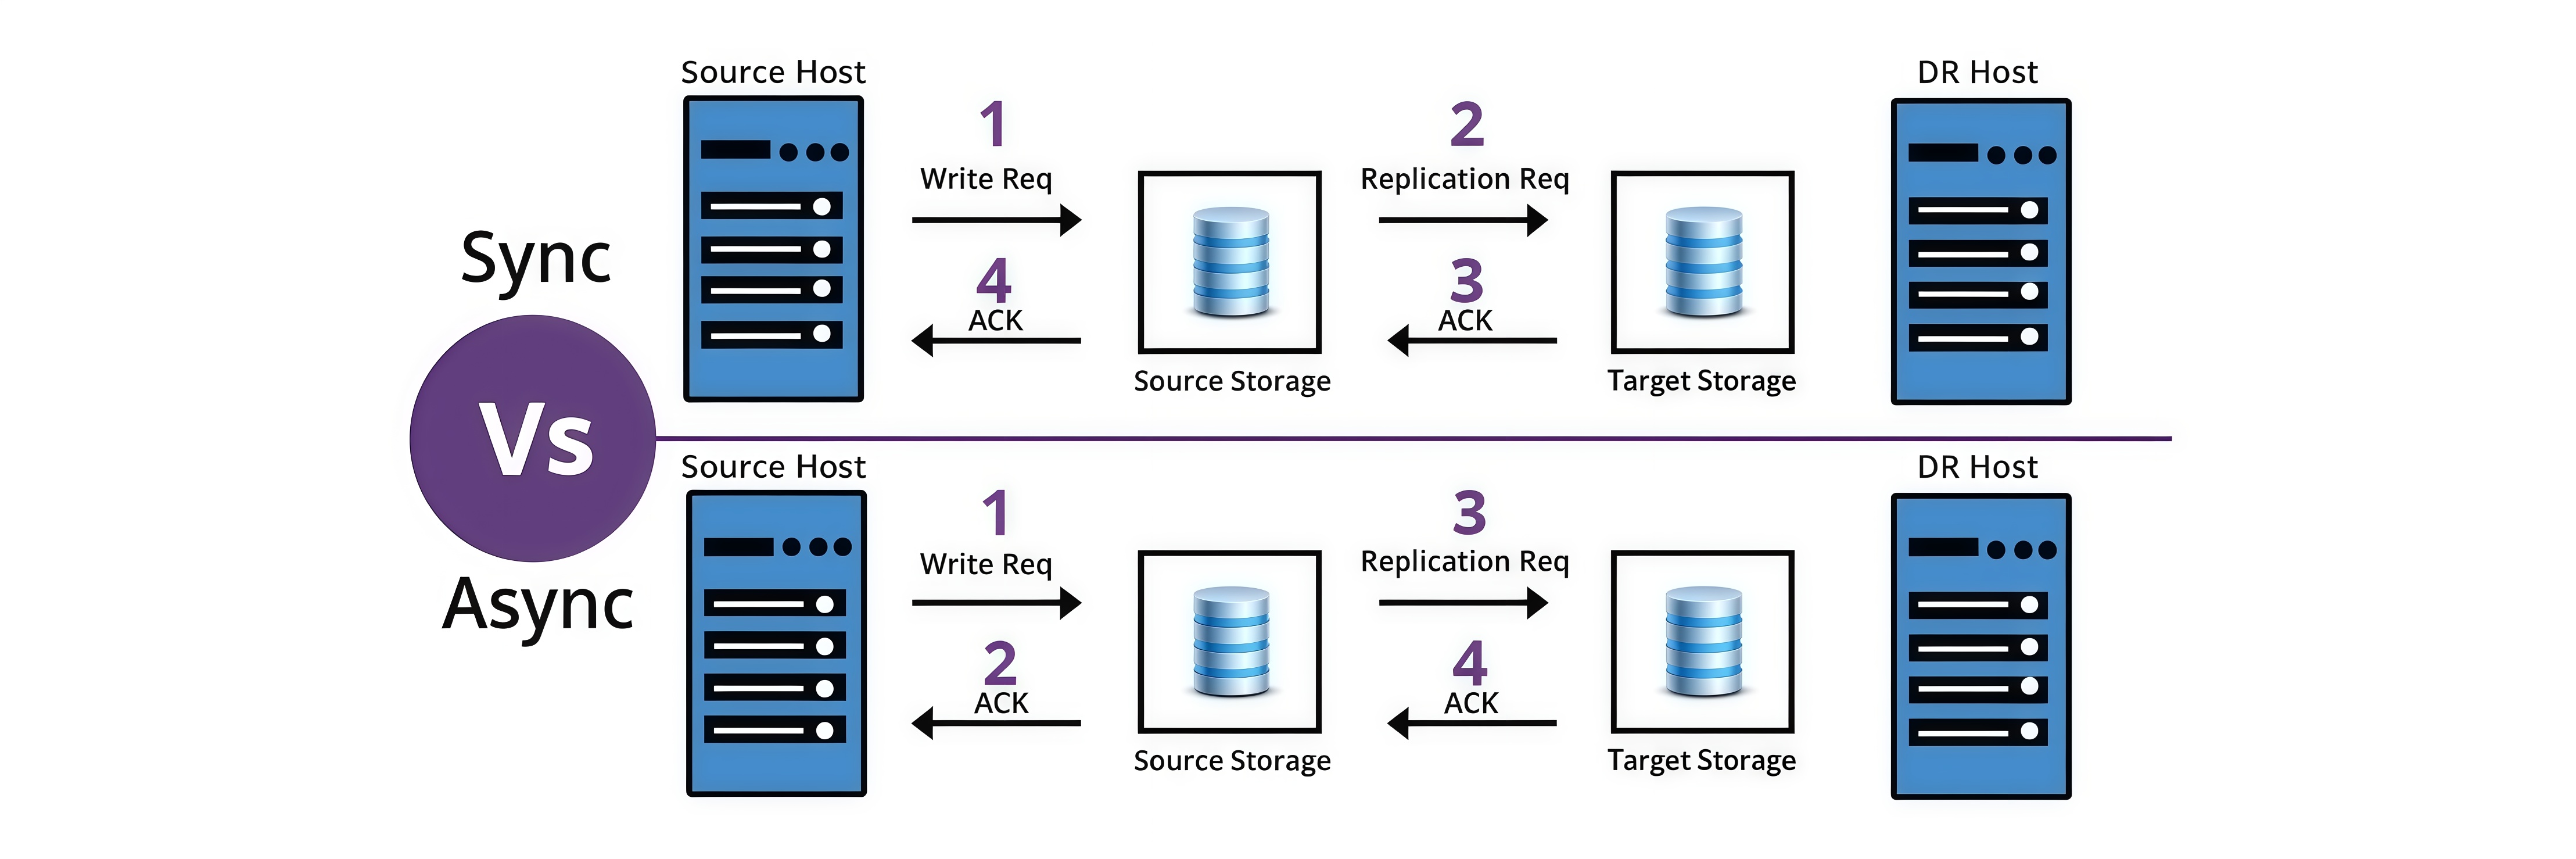
Асинхронная репликация на массивах часто строится на снимках: раз в N минут массив делает снапшот тома и отправляет на второй массив только разницу с предыдущим. Синхронная идёт запись за записью.
Из российских СХД репликацию умеют, например, АЭРОДИСК (синхронный и асинхронный режим, задаётся для каждого тома отдельно, есть метрокластер) и YADRO TATLIN.UNIFIED (синхронная репликация). Перед покупкой уточняйте у поставщика, входит ли репликация в базовую поставку или лицензируется отдельно, и какой канал вендор требует под нужный режим.
Уровень, на котором снимаются изменения, определяет производительность и возможности системы.
Физическая репликация копирует данные блок за блоком, как точную копию диска. Это быстро и эффективно, но негибко. У СУБД реплика должна совпадать с источником по мажорной версии и архитектуре (для PostgreSQL - та же основная версия сервера), выбрать отдельные таблицы нельзя. Репликация между СХД - тоже физическая: массив не знает, что лежит в томе, и копирует всё подряд. Подходит для горячего резерва, не подходит, если нужна только часть данных или копия на другой платформе.
Логическая репликация работает на уровне изменений в базе данных: она понимает, что именно изменилось, и передаёт эту информацию. Можно реплицировать отдельные таблицы, фильтровать данные, даже преобразовывать их на лету. Цена гибкости - дополнительная нагрузка на процессор и сложная настройка.
Триггерная репликация - гибкий, но ресурсоёмкий метод. При каждом изменении срабатывает программный код, который решает, что и куда реплицировать. Так можно встроить бизнес-логику прямо в процесс репликации, но при большом потоке изменений система заметно замедлится.
Если выбираете между логической и физической: для полного резерва всей базы берите физическую, она проще и быстрее. Логическая нужна, когда реплика другой версии, нужна не вся база или данные уходят в другую систему (например, в хранилище для аналитики).
Выбор режима - всегда компромисс. Синхронная репликация гарантирует, что данные записаны в обе системы: запись подтверждается приложению только после ответа реплики. Потерять подтверждённую транзакцию нельзя. Но скорость записи определяется самым медленным звеном - каналом до второй площадки.
Банки используют синхронную репликацию для критичных операций, но в пределах города: площадки ставят на расстоянии десятков километров. На дальние резервные ЦОД данные уходят асинхронно - иначе каждая операция ждала бы ответа за сотни километров.
Асинхронная репликация работает по принципу «записал - отправил следом». Основная система не ждёт подтверждения от реплики, поэтому скорость записи почти не страдает. Платить приходится возможной потерей последних изменений: всё, что не успело уйти по каналу, при аварии пропадёт.
Полусинхронный режим встречается в СУБД (например, в MySQL): система ждёт подтверждения хотя бы от одной реплики, остальные догоняют асинхронно.
| Режим | Когда запись подтверждена | Сколько данных можно потерять (RPO) | Расстояние между площадками | Влияние на скорость записи |
|---|---|---|---|---|
| Синхронный | после записи на обе стороны | ноль | обычно до ~100 км, задержка туда-обратно (RTT) - единицы миллисекунд; точные пределы задаёт вендор | каждая запись ждёт ответа реплики |
| Асинхронный | сразу после записи на источник | от секунд до интервала репликации (минуты) | ограничено только каналом | почти нет |
| Полусинхронный (СУБД) | после ответа хотя бы одной реплики | ноль для этой реплики | как у синхронного для ближней реплики | ждёт самую быструю реплику |
Откуда ограничение по расстоянию - из физики. Свет в оптике идёт примерно 200 000 км/с, 100 км туда и обратно - около 1 мс только на распространение сигнала, плюс коммутаторы и сам массив. Для базы с тысячами мелких записей в секунду каждая лишняя миллисекунда заметна.
Отсюда и ответ на частый вопрос «какой тип репликации даёт минимальную задержку». Минимальную задержку записи даёт асинхронный режим. Минимальные потери данных - синхронный. Выбирать удобнее через два числа: сколько данных бизнес готов потерять и сколько может простоять. Как их посчитать, разобрано в статье RPO и RTO простыми словами.
Архитектура репликации определяет, как системы взаимодействуют друг с другом. Классическая схема master-slave (ведущий и ведомые) проста и предсказуема: один узел принимает все изменения, остальные только читают. Споров о том, какая версия данных правильная, не возникает.
Но что, если ведущий упадёт? Нужно выбрать нового из реплик, и тут начинаются сложности. Какая реплика самая свежая? Как избежать split-brain - ситуации, когда связь между площадками пропала и обе стороны считают себя главными и принимают каждая свои записи?
В топологии master-master писать можно в любой узел. Звучит удобно, особенно для распределённых систем: офис в Москве работает со своим узлом, офис в Екатеринбурге - со своим, данные синхронизируются. Но конфликты неизбежны: что делать, если один и тот же документ одновременно изменили в двух местах?
Каскадная репликация создаёт иерархию: источник реплицирует на первый уровень реплик, те - на второй. Нагрузка на основной узел падает, зато изменения доходят до конечных узлов с задержкой. Для СХД типичный каскад - синхронная копия в соседний ЦОД и оттуда асинхронная на дальнюю площадку.
Репликация - только часть отказоустойчивости: нужны ещё серверы, которые поднимут работу на второй копии. Как это собрать целиком, разобрано в статье про отказоустойчивый кластер с запасом мощности и ёмкости.
Метрокластер - это две СХД на двух площадках, которые за счёт синхронной репликации показывают серверам один и тот же том. Серверы пишут в любой из массивов (режим active-active), а при отказе площадки продолжают работать с оставшимся без ручного переключения.
Против split-brain ставят арбитр (кворум-свидетель) на третьей площадке. Когда пропадает связь между массивами, каждый спрашивает арбитра, кому продолжать работу. Тот, кто не получил ответ, останавливает запись в том. Без третьей площадки автоматика в метрокластере опасна: два массива, потерявшие друг друга, не могут сами решить, кто прав.
Арбитром обычно ставят небольшую виртуальную машину или сервер - в третьем здании, в облаке, в другом офисе. Мощности ему много не нужно, нужна независимая связь с обеими площадками.
Когда оправдан: две серверные в разных зданиях одного города, простой недопустим даже на минуты, есть оптика между площадками. Для большинства небольших компаний это дорого и избыточно. Асинхронная копия на вторую площадку плюс отработанная процедура ручного переключения закрывает те же риски, только простой при аварии составит от десятков минут до пары часов.
Настройка репликации СХД начинается с оценки сети, задолго до интерфейса массива. Сколько данных изменяется в единицу времени? Хватит ли канала для выбранного режима? Многие пропускают этот шаг и потом получают реплику, которая отстаёт всё сильнее.
Для постоянной работы считают объём изменений. Размер тома важен только для первой синхронизации: том на 2 ТБ, в котором за день меняется 20 ГБ, нагружает канал меньше, чем том на 500 ГБ с 200 ГБ изменений.
Пример. За рабочий день (8 часов) в томах меняется 150 ГБ. Средний поток: 150 × 1024 МБ / 28 800 с ≈ 5,3 МБ/с, то есть около 43 Мбит/с. Но записи идут неравномерно: закрытие дня в учётной системе, ночные регламентные задания, перенос архивов. Пики легко бывают в 3-5 раз выше среднего, поэтому для асинхронной реплики с RPO в несколько минут закладывайте 150-200 Мбит/с. Для синхронной считают по пиковому потоку записи с запасом. Если на пике канала не хватит, замедлятся сами серверы: они ждут подтверждения каждой записи.
Где взять объём изменений: статистика записи в интерфейсе массива, размер снапшотов за сутки, счётчик Disk Write Bytes/sec в Windows или iostat в Linux. Снимайте хотя бы неделю, включая конец месяца.
На уровне СХД дополнительно настраивают снапшоты и журналирование изменений. Аппаратная репликация на массиве быстрая и не нагружает серверы, но привязывает к вендору. Программная универсальнее, но расходует ресурсы сервера.
Мониторинг репликации - отдельная история. Мало знать, что репликация «работает». Отслеживайте задержку репликации (replication lag), размер очереди изменений, количество конфликтов. Растущая задержка - первый признак проблем, которые лучше решить до того, как они станут критичными.
Реплика, на которую ни разу не переключались, - это надежда, а не резерв. Типичные находки при первом тесте: сервисы на второй площадке ссылаются на IP-адреса первой, лицензии привязаны к старому железу, никто не помнит порядок запуска. Проверяйте переключение хотя бы раз в полгода и после крупных изменений.
Четыре технологии часто живут в одном массиве, а в разговоре их легко спутать. Разница - в том, где лежит копия и от чего она защищает.
| Что это | Где лежит копия | Сбой массива | Удаление или шифровальщик | Зачем нужна | |
|---|---|---|---|---|---|
| Снапшот | снимок тома на момент времени, ссылается на исходные блоки | на том же массиве | не спасает | спасает, пока снимки целы | быстрый откат после неудачного обновления |
| Клон | полная независимая копия тома на момент создания | обычно на том же массиве | не спасает | спасает на момент клона | тестовая среда, копия базы для отчётов |
| Репликация | постоянно обновляемая копия | на другом массиве или площадке | спасает | не спасает: ошибка копируется | продолжить работу при отказе |
| Бэкап | копия в отдельной системе с историей версий | отдельно, лучше вне площадки | спасает | спасает, если копия отключена или неизменяема | восстановление на нужную дату |
Клон отличается от репликации тем, что создаётся один раз и дальше живёт своей жизнью. Реплика продолжает получать все изменения. Про подводные камни снимков - в статье когда применять снапшоты виртуальных машин, про бэкап самих хранилищ - в разборе резервного копирования СХД.
Для небольшой компании типичный сценарий выглядит скромнее, чем у маркетплейса. Сервер 1С и файловое хранилище в офисе, копия виртуальных машин на втором сервере в другом здании или в арендованной стойке. Асинхронная репликация раз в 5-15 минут, при аварии ВМ запускают на втором сервере вручную. При пожаре или затоплении серверной компания потеряет последние 5-15 минут данных и час-другой на запуск машин. Без реплики счёт шёл бы на дни.
В электронной коммерции репликация решает задачу географического распределения. Покупатели из Владивостока получают данные с ближайшего сервера, не дожидаясь ответа из Москвы. Критичные данные (остатки товара, заказы) синхронизируются в реальном времени, а каталог товаров может обновляться асинхронно.
Аналитические системы используют репликацию, чтобы разделить транзакционную и аналитическую нагрузку (OLTP и OLAP). Рабочая база обрабатывает операции, а её реплику отдают под отчёты. Тяжёлые запросы не тормозят основную систему.
В больших данных у репликации есть второе назначение - локальность вычислений. Hadoop по умолчанию хранит три копии каждого блока на разных узлах. Данные обрабатываются там, где лежат физически, сетевого трафика меньше.
Два одинаковых массива с лицензией на репликацию - серьёзные деньги. Для малого и среднего бизнеса чаще подходит программная репликация между обычными серверами. Она асинхронная (кроме DRBD и Storage Replica в синхронном режиме), зато работает на том железе, что уже есть.
| Инструмент | Что реплицирует | Режим | Ограничения |
|---|---|---|---|
| Proxmox VE (встроенная репликация) | диски ВМ и контейнеров между узлами кластера | асинхронный, интервал от 1 минуты, по умолчанию раз в 15 минут | только локальный ZFS; при отказе узла теряются изменения после последней синхронизации |
| ZFS send/receive | снапшоты датасетов на другой сервер | асинхронный, по расписанию | нужен ZFS с обеих сторон, расписание настраивается отдельно (cron, syncoid) |
| DRBD | блочное устройство между двумя Linux-серверами | протокол C - синхронный, A - асинхронный | сеть между узлами должна выдерживать поток записи; split-brain решается настройками кластера |
| Windows Server Storage Replica | тома между серверами или кластерами | синхронный или асинхронный | в редакции Standard (2019 и новее) - один том до 2 ТБ, в Datacenter без этих ограничений |
| Hyper-V Replica | виртуальные машины Hyper-V | асинхронный, интервал 30 секунд, 5 или 15 минут | ручное или скриптовое переключение |
| Репликация СУБД | базу данных (PostgreSQL, MS SQL и др.) | зависит от СУБД | копируется только база, остальное защищать отдельно |
Часто дешевле реплицировать только то, что дорого потерять. База 1С на PostgreSQL с потоковой репликацией на второй сервер защищена лучше, чем весь файловый сервер со старыми архивами, скопированный раз в сутки.
Для ZFS-вариантов стоит разобраться в самой файловой системе: что даёт ZFS и кому она нужна.
Выбор инструмента зависит от технологий, на которых построена система. PostgreSQL предлагает встроенную потоковую репликацию с каскадными схемами. MySQL традиционно силён в схеме ведущий-ведомые, а Galera Cluster добавляет запись в любой узел (multi-master).
Для разнородных систем есть специализированные решения. Apache Kafka стал стандартом для передачи потоков данных между системами. Debezium превращает изменения в базах данных в события, которые можно обрабатывать и маршрутизировать.
Облачные провайдеры предлагают управляемые сервисы. AWS Database Migration Service реплицирует данные между разными типами баз с минимальным простоем. В Azure SQL Database геореплики и группы автоматической отработки отказа настраивает сам пользователь. Российским компаниям AWS и Azure с 2022 года фактически недоступны, похожие управляемые сервисы есть у российских облачных провайдеров.
Репликация - инструмент, а не самоцель. Прежде чем строить схему синхронизации, определите, какую проблему решаете. Бывает, что хватает хорошего бэкапа:
И обратная ситуация: даже продуманная репликация не спасёт от неудачно спроектированной архитектуры. Если приложение не умеет переподключаться к другому серверу, копия данных на второй площадке сама его не поднимет.
Асинхронный: запись подтверждается сразу, не дожидаясь второй площадки. Синхронный режим добавляет к каждой записи время ответа реплики, зато не теряет данные.
Клон - разовая полная копия тома на определённый момент, обычно на том же массиве. Реплика лежит на другом массиве и постоянно получает все новые изменения.
Через Fibre Channel или Ethernet (порты репликации, iSCSI) по оптике между площадками. Канал должен выдерживать пиковый поток записи, а задержка туда-обратно - укладываться в требования вендора, обычно единицы миллисекунд.
Физическую - для полной резервной копии всей базы той же версии. Логическую - если нужна часть данных, другая версия СУБД или передача данных в другую систему.
Нет. Репликация спасает от отказа оборудования и площадки, но копирует удаление и шифрование данных. Бэкап с историей версий нужен в любом случае.
Планируете вторую площадку или резервную СХД?
Инженеры ITTELO подберут систему хранения и серверы под ваш объём изменений и требования к простою, соберут и протестируют конфигурацию перед отгрузкой, с гарантией и поддержкой после продажи. На рынке серверов 11+ лет.
Системы хранения данных · +7 (800) 551-80-12 · info@ittelo.ru