Эксперты в подборе IT-оборудования
Регламент замены жёстких дисков на сервере - это набор правил, которые отвечают на три вопроса: когда диск пора менять, кто и как это делает и что должно быть готово заранее, чтобы замена прошла без остановки сервиса. Регламент - это не инструкция «какой отвёрткой откручивать»: физическая процедура занимает пять минут, а всё остальное решается до того, как диск начал сыпаться.
Главное отличие серверного диска от десктопного здесь принципиальное. Диск в сервере меняют горячим - не выключая сервер и не снимая крышку. Если вы встречаете совет остановить сервер, отсоединить кабель питания и кабель данных от диска, - это инструкция для настольного компьютера, и к стоечному серверу она не имеет отношения.
Диск меняют в трёх ситуациях, и они требуют совершенно разной срочности.
Отказ уже произошёл. Диск не определяется контроллером, вылетел из массива, RAID перешёл в состояние degraded. Здесь думать не о чем: меняем сейчас, потому что до восстановления избыточности массив живёт без запаса прочности.
Диск ещё работает, но подаёт сигналы. Растёт число переназначенных секторов, появляются ошибки чтения, контроллер помечает диск как подозрительный, время отклика заметно выросло относительно соседей в массиве. Это плановая замена: её можно назначить на удобное окно, но откладывать на месяцы не стоит.
Диск здоров, но исчерпал ресурс по регламенту. Отработал заявленный срок, вышел из гарантии, относится к партии с известными проблемами. Замена по календарю, а не по симптомам.
Какие именно показатели считать сигналом и как читать отчёт диска - тема отдельная и подробная: значения атрибутов, ложные срабатывания и то, какие показатели реально предсказывают отказ, разобраны в статье про SMART-мониторинг дисков на серверах.
Разница между «сейчас» и «планово» - это не вкусовщина, а расчёт риска. В массиве с одинарной избыточностью (RAID 5, RAID 1) отказ одного диска съедает весь запас: следующий отказ означает потерю данных. В RAID 6 или RAID 10 запас есть, но он тоже конечен.
| Ситуация | Срочность | Почему |
|---|---|---|
| Диск вылетел, массив degraded, hot-spare нет | немедленно | массив без избыточности, второй отказ - потеря данных |
| Диск вылетел, hot-spare подхватил | в ближайшие дни | избыточность восстанавливается автоматически, но запас израсходован |
| Растут ошибки, диск ещё в массиве | плановое окно | есть время выбрать момент и подготовить замену |
| Ресурс по календарю исчерпан, симптомов нет | планово, партиями | удобно совмещать с другими работами |
Отдельно про то, чего делать не надо: менять здоровые диски «для профилактики производительности». В сервере диск в составе массива не начинает работать быстрее оттого, что он новый, а лишняя замена - это лишний ребилд, то есть лишний риск.
Регламент существует ради этого раздела. Когда диск уже вылетел, поздно выяснять, есть ли на складе такой же.
Запас ЗИП. Держите на полке хотя бы один диск той же модели и ёмкости на каждый тип массива. Диск, купленный «когда понадобится», приезжает через недели, а массив всё это время живёт без избыточности. Для критичных систем разумный ориентир - один запасной на каждые 8-12 рабочих дисков, но точнее считать от сроков поставки: чем дольше везут, тем больше запас.
Hot-spare в массиве. Диск горячего резерва стоит в корзине, крутится вхолостую и вступает в дело автоматически, как только контроллер отбраковал рабочий. Это переводит ситуацию из «немедленно» в «в ближайшие дни» - самая дешёвая покупка спокойствия из всех возможных.
Проверенная резервная копия. Ребилд - момент повышенной нагрузки на оставшиеся диски, и именно во время него иногда вылетает второй. Копия должна существовать и восстанавливаться, а не просто числиться в отчёте.
Совместимость. Диск на замену должен подходить контроллеру по интерфейсу, а массиву - по ёмкости и, желательно, по модели. Диск меньшего объёма в массив не встанет; диск большего встанет, но излишек пропадёт. Что бывает и чем модели отличаются между собой - в разборе, какие бывают жёсткие диски.
Журнал замен. Простая таблица: дата, слот, серийные номера снятого и поставленного, причина. Через год она отвечает на вопросы «эта партия сыпется?» и «когда мы вообще этот диск ставили?».
Сама процедура на стоечном сервере с горячей заменой выглядит так.
Пошаговый разбор с оговорками под конкретные контроллеры - в отдельной инструкции, как заменить жёсткий диск на сервере.
Чего делать нельзя: выдёргивать диск, который контроллер считает рабочим; вынимать сразу два диска; извлекать диск во время ребилда. И не стоит менять диск в массиве без избыточности - там сначала копия, потом всё остальное.
Восстановление массива - не формальность, а тот момент, когда чаще всего теряют данные.
Пока идёт ребилд, контроллер читает все данные с оставшихся дисков, чтобы пересчитать содержимое нового. Диски одной партии, отработавшие одинаковое время под одинаковой нагрузкой, оказываются под пиковой нагрузкой одновременно - и если один уже был на грани, вылетает он именно сейчас. В массиве с одинарной избыточностью это означает потерю данных.
Отсюда несколько практических следствий.
Время ребилда растёт вместе с ёмкостью дисков: чем крупнее диски, тем дольше окно риска. Для многотерабайтных дисков оно измеряется часами, а под нагрузкой - и сутками. Это аргумент в пользу RAID 6 или RAID 10 на больших ёмкостях: они переживают отказ во время восстановления. Как устроены уровни и чем они отличаются по запасу прочности - в материале о том, что такое RAID.
Ребилд стоит запускать в период низкой нагрузки, если ситуация позволяет ждать. И не стоит в это время делать что-то ещё с массивом.
Полезная привычка: не набивать массив дисками из одной партии. Разные партии - разный износ и меньше шансов получить одновременный отказ.
Определить нужный диск можно тремя способами, и лучше пользоваться сразу двумя.
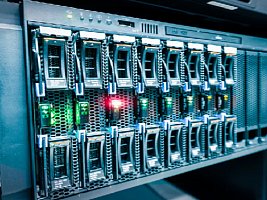
Индикация на корзине. Проблемный диск подсвечивается отдельно. Большинство контроллеров умеет по команде подсветить конкретный слот - это самый надёжный способ убедиться, что вы тянете тот диск.
Утилита контроллера. Показывает состояние каждого диска, его серийный номер и положение в массиве. Серийник - главный ориентир: он написан на самом диске, и его можно сверить перед извлечением.
Средства удалённого управления сервером. iLO у HPE, iDRAC у Dell и их аналоги показывают состояние дисков и подсвечивают нужный слот, не подходя к стойке. Удобно, когда сервер стоит в другом здании, а руки в серверной - чужие.
Если сомневаетесь, какой диск проблемный, не действуйте наугад. Сверьте серийный номер и подсветите слот - это занимает минуту и спасает от потери массива.
Не всякая проблема с дисковой подсистемой - это умирающий диск.
Перегрев. Забитые пылью фильтры, вышедший из строя вентилятор, слишком плотная стойка. Диск при этом исправен, а ошибки идут. Лечится обслуживанием охлаждения, а не заменой диска.
Проблемы с контроллером или кабелем. Вылетают сразу несколько дисков, ошибки появляются группами - это повод посмотреть на контроллер, а не на носители.
Устаревшая прошивка. У дисков и контроллеров бывают известные дефекты, закрытые обновлением. Перед заменой стоит проверить, нет ли для вашей модели свежей прошивки.
Заполненный том. Заканчивающееся свободное место выглядит как «диск тормозит», но диск тут ни при чём.
Общее правило: прежде чем менять диск, убедитесь, что проблема в диске. Замена исправного носителя не чинит ничего, зато запускает ребилд со всеми его рисками.
Заменить можно, и обычно это оправдано, но не «на ходу» в составе существующего массива.
Смешивать в одном массиве SSD и HDD не следует: массив будет работать со скоростью самого медленного участника, а износ у носителей разный. Правильный путь - менять массив целиком либо выделять SSD под отдельный том.
Выигрыш будет заметен там, где нагрузка состоит из множества мелких операций: базы данных, виртуализация, файловые сервисы с большим числом одновременных обращений. Для последовательной записи больших файлов - видеонаблюдение, архивы, резервные копии - разница окажется куда скромнее, а цена за терабайт останется существенно выше.
Стоимость складывается из трёх частей: сам диск, работа по замене и простой, если он был. Первая зависит от типа, ёмкости и интерфейса; вторая - от того, свои силы или подрядчик; третья - от того, была ли избыточность и запас на полке.
Именно поэтому регламент экономит деньги, а не создаёт бюрократию: диск на складе и hot-spare в корзине превращают аварию в плановую работу. Точную цену под ваши модели и объёмы посчитаем - это дешевле, чем считать убытки от простоя.
Здесь стоит развести две вещи, которые часто путают: гарантийный срок и реальную наработку.
Гарантия на серверные диски обычно составляет от трёх до пяти лет в зависимости от модели и класса. Это обязательство производителя, а не предсказание отказа: диск может отработать дольше и может выйти из строя раньше.
Реальная картина по отказам скорее обнадёживает. По данным сервиса Backblaze, который публикует статистику по своему парку из сотен тысяч дисков, годовой процент отказов за 2025 год составил 1,36% - это ниже показателя 2024 года (1,55%) и самый низкий результат с 2022-го. Накопленный показатель за всё время наблюдений держится около 1,30%. Отчёт охватывает 344 тысячи дисков и тринадцать лет наблюдений, так что порядок величины можно считать надёжным.
Что из этого следует для регламента. Отказы - явление редкое, но при парке в несколько десятков дисков они происходят регулярно: полтора процента в год от сотни дисков означает примерно полтора отказа ежегодно. Планировать надо не «если», а «когда».
На срок службы сильнее календаря влияют условия: температура, вибрация в плотно набитой корзине, характер нагрузки и качество питания. Диск в прохладной стойке с ровным питанием переживёт диск в душном шкафу с просадками напряжения независимо от того, что написано в гарантийном талоне.
Практический вывод: на календарь ориентируйтесь при планировании бюджета, на состояние конкретного диска - при решении о замене. Заменять всю партию разом при исчерпании гарантии нет смысла; следить за состоянием и держать запас - есть.
Можно ли менять диск, не выключая сервер?
На стоечных серверах с корзиной горячей замены - да, для этого она и нужна. Убедитесь, что контроллер отбраковал диск или что вы перевели его в offline, и меняйте.
Обязателен ли диск той же модели?
Тот же интерфейс и не меньшая ёмкость - обязательно. Та же модель - желательно: контроллеры спокойнее относятся к однородным массивам, а поведение под нагрузкой предсказуемее.
Что делать, если во время ребилда вылетел второй диск?
В массиве с одинарной избыточностью - останавливаться и восстанавливаться из резервной копии. Попытки «дособрать» массив своими силами в этой ситуации чаще добивают данные, чем спасают.
Сколько запасных дисков держать?
Считайте от сроков поставки, а не от числа дисков. Если нужную модель везут месяц - держите больше; если она есть у поставщика на складе и приезжает за день - хватит одного на тип массива.
Нужен ли hot-spare, если есть запас на полке?
Hot-spare начинает восстановление сразу, без участия человека, - в том числе ночью и в выходные. Полка требует, чтобы кто-то пришёл. Для критичных систем это разные уровни готовности.
Регламент замены дисков сводится к нескольким пунктам: следить за состоянием, а не ждать отказа; держать запас и hot-spare; проверять резервную копию до, а не после; менять горячим и в правильный слот; помнить, что ребилд - самое опасное окно; записывать, что и когда меняли.
Ничего сложного здесь нет. Сложное начинается тогда, когда диск вылетел, запасного нет, копия не проверялась, а массив собран из одной партии дисков одного возраста.
Подбираете диски на замену или собираете дисковую подсистему с запасом?
Инженеры ITTELO помогут подобрать диски под ваш контроллер и массив - по интерфейсу, ёмкости и классу нагрузки, включая запас ЗИП под парк. Соберём и протестируем конфигурацию под задачу перед отгрузкой, с гарантией и поддержкой после продажи. На рынке серверов 11+ лет, и с подбором совместимой замены под снятые с производства модели сталкиваемся регулярно.
серверный жесткий диск · +7 (800) 551-80-12 · info@ittelo.ru