
Эксперты в подборе IT-оборудования
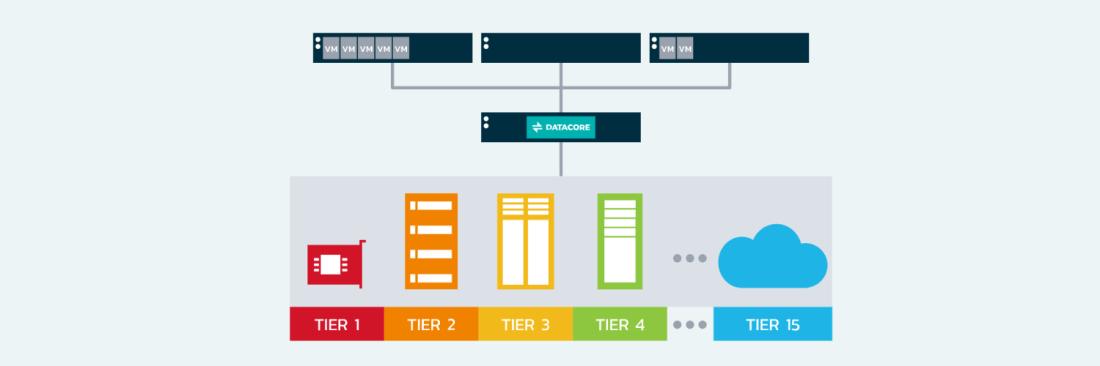
Знаете, какая самая дорогая ошибка в управлении данными? Хранить архивы пятилетней давности на NVMe-дисках за космические деньги, пока критически важные базы данных тормозят на старых HDD. Звучит абсурдно? А между тем такая ситуация встречается чаще, чем вы думаете. Компании либо покупают дорогое железо для всех данных подряд и разоряются, либо экономят на всём и теряют в производительности. И вот здесь на помощь приходит tiering хранения данных - технология, которая решает извечную дилемму между скоростью и стоимостью.
Давайте начнём с простого факта: не все данные одинаково полезны. Финансовый отчёт, который генерируется раз в квартал и потом лежит мёртвым грузом - это одно. База данных интернет-магазина, к которой обращаются тысячи раз в секунду - совсем другое. Tiered storage, или многоуровневое хранение, строится именно на этом принципе: разные данные заслуживают разного отношения.
Представьте систему хранения как многоэтажный паркинг. На первом этаже, у самого выхода - места для тех, кто постоянно приезжает и уезжает. Это ваши NVMe SSD: очень быстрые и очень дорогие. Второй этаж - обычные SSD, для тех, кто паркуется на день-два. Третий - ёмкие HDD для того, что нужно редко, но должно быть под рукой. И где-то в подвале - долгосрочная стоянка: лента или объектное хранилище, куда данные уезжают на годы.
Вот как это выглядит без метафор:
| Уровень | Типичная задержка | Что кладём | Чего сюда не кладём |
|---|---|---|---|
| NVMe SSD | десятки-сотни микросекунд | активная часть БД, индексы, метаданные, кэш виртуализации | архивы, логи «на всякий случай» |
| SATA/SAS SSD | доли миллисекунды | рабочие файловые шары, образы ВМ, свежие бэкапы | то, к чему не обращались месяцами |
| HDD большой ёмкости | единицы-десятки миллисекунд | архивы с редким доступом, вторые копии, медиа | всё, что требует предсказуемого отклика |
| Лента, объектное хранилище | от секунд до часов | долгосрочные архивы, копии для регуляторики | то, что может понадобиться срочно |
Нижний уровень заслуживает отдельного разговора: как устроено долгосрочное хранение редко используемых данных и во что обходится извлечение оттуда, разобрано в отдельной статье. Про саму ленту - когда ленточные библиотеки ещё оправданы.
Чего в таблице нет - так это разделения на SAS- и SATA-диски как на два разных уровня. В старых материалах эта ступенька встречается постоянно, но сегодня она мало что значит: SAS и SATA различаются интерфейсом и тем, как ведут себя в многодисковых полках, а не классом производительности. Реальные ступени задаёт тип носителя, а не разъём.
Современные СХД умеют определять, какие данные к какому уровню относятся. Система анализирует паттерны доступа: как часто к блоку обращаются, насколько быстрый отклик нужен, критичны ли данные для бизнеса. На основе этого данные мигрируют между уровнями. Вчерашние «горячие» новости становятся «тёплыми», а потом и вовсе остывают до архивного состояния.
Что интересно, миграция происходит не на уровне файлов целиком, а на уровне блоков. Если в огромной базе данных активно используется только десятая часть записей, именно она будет жить на быстрых дисках, а остальное спокойно переедет на медленные и дешёвые носители. Размер блока миграции у разных вендоров свой - от сотен килобайт до нескольких мегабайт; это стоит уточнять по документации конкретной модели, потому что от него зависит, насколько тонко система различает горячее и холодное.
Теперь к цифрам, которые любит финансовый директор. Типичное распределение данных в корпоративной среде: единицы процентов - критически важные «горячие» данные, четверть или треть - периодически используемые «тёплые», остальное - «холодные» архивы. Это эмпирический ориентир, а не норматив: у видеонаблюдения и у биллинга картина будет совершенно разной, и первое, что стоит сделать перед внедрением, - померить своё распределение, а не поверить чужому.
Но даже грубого прикидывания хватает, чтобы увидеть суть. Без tiering у вас два пути: держать все сто процентов на дорогих быстрых дисках или всё на медленных. Первое разоряет, второе тормозит.
Считать экономию лучше самостоятельно, и арифметика здесь простая. Возьмите цену за терабайт на каждом уровне и посмотрите на разрыв: NVMe корпоративного класса стоит кратно дороже ёмкого HDD в пересчёте на терабайт. Если из ста терабайт по-настоящему горячих у вас пять, то заменив «плоскую» конфигурацию на многоуровневую, вы платите полную цену за эти пять, а за остальные девяносто пять - цену нижнего уровня. Умножьте на свой разрыв в цене за терабайт и получите свою экономию, а не среднюю по больнице.
С производительностью так же: выигрыш есть, но он не в процентах из презентации. Смысл в том, что критичные данные всегда лежат на быстрых носителях, и важный запрос не стоит в очереди за обращением к архиву. Насколько это ускорит именно ваше приложение, зависит от того, какая доля обращений сейчас уходит на медленный уровень. Померить это можно до всякой закупки - по статистике доступа.
Энергопотребление - ещё один бонус. NVMe потребляют много, но их у вас немного. Основной объём приходится на HDD, которые экономичнее в пересчёте на ватт на терабайт. В масштабах дата-центра это снижение расходов на электричество и охлаждение.
Стоит только помнить, что tiering - не единственный способ сэкономить на ёмкости и часто не первый. Дедупликация и сжатие данных дают эффект без перемещения чего-либо между уровнями, и начинать разумно с них: они проще во внедрении и не создают риска промахов.
Автоматическое перемещение данных между уровнями - это не скрипт, который раз в сутки что-то куда-то копирует. Современные системы используют алгоритмы анализа, которые учитывают множество факторов.
Частота доступа - очевидный, но не единственный критерий. Система анализирует также время последнего обращения, размер блоков, тип операций (чтение или запись), даже время суток. База данных может быть горячей в рабочее время и остывать ночью. Умная система это учтёт.
Некоторые системы идут дальше и используют предиктивную аналитику. Они не просто реагируют на текущие паттерны, но и предсказывают будущие потребности. Квартальный отчёт всегда генерируется первого числа? Система заранее подогреет нужные данные, переместив их на быстрый уровень.
Важный момент - гранулярность перемещения. Старые системы двигали файлы целиком, что было неэффективно для больших файлов с неравномерным доступом. Современный tiering работает на уровне блоков, и это позволяет держать наверху только реально используемые части данных.
Автоматика - это хорошо, но иногда нужен ручной контроль. Политики tiering настраиваются детально, под специфику конкретного бизнеса.
Можно задать минимальное время выдержки на уровне. Например, все новые данные сначала попадают на быстрый уровень и остаются там минимум сутки, независимо от активности. Это гарантирует быстрый доступ к свежей информации.
Или наоборот - можно установить агрессивную политику экономии, когда данные переезжают на более дешёвый уровень уже через несколько часов неактивности. Подходит для сред разработки и тестирования, где данные быстро теряют актуальность.
Интересная опция - пиннинг, или закрепление. Вы можете явно указать, что определённые данные должны всегда оставаться на конкретном уровне. Критичная база данных? Закрепляем на NVMe. Архив за 2015 год? Отправляем на нижний уровень и забываем.
Расписание миграции - ещё один важный параметр. Перемещение данных создаёт нагрузку на систему, поэтому разумно выполнять его в часы минимальной активности. Многие настраивают агрессивный tiering на выходные и ночное время.
Виртуализированные среды и tiering созданы друг для друга. В типичной инфраструктуре у вас сотни виртуальных машин с совершенно разными профилями нагрузки. Контроллер домена крутится вхолостую почти всё время. База 1С работает в полную силу с девяти до шести. Веб-сервер испытывает пиковые нагрузки непредсказуемо.
Без tiering пришлось бы либо обеспечить всем ВМ одинаково высокую производительность, либо вручную распределять их по разным хранилищам. Автоматический tiering решает это изящно: каждая ВМ получает тот уровень производительности, который ей нужен прямо сейчас.
А вот дальше - поворот, о котором стоит знать, потому что он ломает привычную картину. Отрасль местами разворачивается от тиринга обратно. Классическая vSAN OSA строилась на дисковых группах с кэширующим устройством и уровнем ёмкости, то есть на двух ступенях. Пришедшая ей на смену vSAN ESA устроена однослойно: выделенного кэширующего уровня в ней нет, все NVMe-устройства узла дают и ёмкость, и производительность сразу.
Причина простая: когда весь массив собран на быстрых NVMe, делить его на «быстрый» и «медленный» уровни бессмысленно - выигрыш от миграции не окупает её накладных расходов. Так что tiering - решение для смешанных конфигураций, а не универсальное будущее. Если вы строите all-flash с нуля, вопрос «а какой у него тиринг» может оказаться просто неуместным.
Смешанные конфигурации при этом никуда не делись, и у них своя механика: как связка SSD с HDD работает на уровне одного массива, разобрано в материале про гибридные системы хранения.
Облачные провайдеры, наоборот, тиринг развивают. У Amazon S3 сегодня не три класса, а больше: Standard для горячих данных, Standard-IA для тёплых, и три отдельных архивных - Glacier Instant Retrieval (достать за миллисекунды), Glacier Flexible Retrieval и Glacier Deep Archive (самый дешёвый, извлечение часами). Отдельно стоит S3 Intelligent-Tiering - и это прямой облачный аналог всего, о чём мы говорим: класс сам перекладывает объекты между уровнями доступа по мере того, как меняются паттерны обращения, с порогами в 30, 90 и 365 дней. Если вы хотите посмотреть на автоматический tiering, ничего не покупая, начните с него.
Машинное обучение выводит tiering на новый уровень. Вместо простых правил «не использовалось 30 дней - переместить вниз» алгоритмы выявляют сложные паттерны, невидимые человеческому глазу.
Например, система может обнаружить, что определённые файлы всегда запрашиваются вместе, хотя формально между ними нет связи. Или что доступ к некоторым данным имеет сезонный характер: активность в конце квартала, затишье в середине. Системы на жёстких правилах такие тонкости упускают.
Флагманские зарубежные СХД - Dell PowerMax, HPE Alletra Storage MP, NetApp AFF - используют аналитику для оптимизации размещения данных. Оценивать выигрыш стоит осторожно: вендорские цифры получены на их собственных сценариях, и на вашей нагрузке результат будет другим. Проверяется это только тестом на своих данных.
Предиктивная аналитика готовит систему к будущим нагрузкам заранее. Если алгоритм видит, что каждый понедельник в девять утра начинается всплеск обращений к определённым данным, он заранее переместит их наверх. Никаких тормозов в начале рабочей недели.
Теперь о том, что обычно умалчивают вендоры. Tiering решает не все задачи, и в некоторых случаях создаёт больше проблем, чем решает.
Первая проблема - непредсказуемые нагрузки. Если ваши паттерны доступа хаотичны и меняются каждый день, система будет постоянно гонять данные туда-сюда, создавая лишнюю нагрузку. В таких случаях проще держать всё на среднем по производительности уровне.
Вторая - маленькие объёмы данных. Если у вас всего 10-20 ТБ, накладные расходы на tiering могут не окупиться. Проще купить SSD на весь объём и не морочить голову. Для большинства компаний малого и среднего бизнеса это и есть правильный ответ: многоуровневое хранение начинает окупаться там, где холодные данные измеряются сотнями терабайт, а не десятками.
Третья - требования к задержкам. Некоторые приложения требуют гарантированной низкой латентности. Если данные внезапно окажутся на медленном уровне, приложение может сломаться. Для таких случаев нужны жёсткие политики пиннинга или отказ от tiering.
Миграция данных сама по себе создаёт нагрузку. Если система постоянно что-то перемещает, это съедает IOPS и пропускную способность. В худшем случае tiering начнёт мешать основной работе.
Вопрос, которого нет в большинстве обзоров, хотя для закупки он часто решающий. Всё, что перечислено выше из зарубежного, приобрести и поддерживать сейчас непросто, а под требование реестра оно не проходит в принципе.
Из отечественных систем многоуровневое хранение заявляет Аэродиск: гибридные конфигурации с SSD-кэшированием и перемещением данных между уровнями. Оборудование компании входит в реестр Минпромторга, программное обеспечение - в реестр Минцифры, то есть под формальные требования закупки оно проходит.
RAIDIX с 2022 года входит в состав YADRO, его программное обеспечение включено в реестр российского ПО. Это программно-определяемое хранилище: вы ставите его на серверную платформу и получаете СХД, а не покупаете готовый шкаф.
Практический вывод для закупки простой. Есть требование реестра - смотреть надо на отечественные платформы, и уточнять состав функций по конкретной версии, а не по общему описанию: многоуровневое хранение у разных вендоров реализовано по-разному и не всегда входит в базовую поставку. Требования нет и парк уже зарубежный - работаете с тем, что стоит, но закладывайте в план, что поддержка и запчасти будут сложнее.
Системы резервного копирования и tiering - отдельная история. С одной стороны, бэкапы идеально подходят для многоуровневого хранения: свежие копии нужны быстро, старые могут лежать на самых медленных носителях.
С другой стороны, есть нюансы. При восстановлении вам может срочно понадобиться бэкап годичной давности. Если он на ленте в удалённом хранилище, восстановление займёт часы. Поэтому для бэкапов часто используют отдельные политики: критичные системы держат наверху дольше, некритичные уезжают в архив быстрее.
Проверять тут надо не политику, а результат. Регулярное тестовое восстановление с нижнего уровня показывает реальное время выхода из аварии - и нередко оказывается, что оно не укладывается в те сроки, которые бизнес считал согласованными.
Здесь придётся поправить прогноз, который до недавнего времени звучал во всех материалах по теме. Считалось, что между оперативной памятью и SSD появится новый уровень на памяти класса storage-class memory, и главным кандидатом был Intel Optane. Этого не произошло. Intel объявила о прекращении разработки Optane ещё в 2022 году, а поставки серверных модулей завершились к концу 2025-го. Строить планы на этот уровень больше нельзя, и если вы встречаете Optane в списке перспективных технологий, материал устарел.
Происходит другое: NVMe дешевеет, и нижняя граница «быстрого» уровня опускается. Отсюда и разворот в гиперконвергентных платформах, о котором говорилось выше, - там, где раньше нужны были две ступени, теперь хватает одной.
Одновременно нижний уровень уходит в объектные хранилища и в облако. Гибридные схемы, где горячее лежит локально, а холодное - в объектном хранилище, вытесняют классическую ленту в тех сценариях, где не нужна полная автономность от сети. Лента при этом никуда не делась: у неё остаётся стоимость хранения и физическая изоляция от сети, а это аргумент против шифровальщиков.
Если вы решили внедрять tiering, начните с анализа текущих данных. Посмотрите статистику доступа за последние три-шесть месяцев. Сколько данных реально горячие? Это поможет правильно рассчитать ёмкости уровней - и, возможно, покажет, что тиринг вам не нужен.
Не гонитесь за максимальным количеством уровней. Для большинства компаний достаточно трёх: быстрый (NVMe или SSD), ёмкий (HDD) и архивный (лента или объектное хранилище). Больше уровней - больше сложности в управлении при почти том же результате.
Начните с консервативных политик. Лучше держать данные наверху чуть дольше необходимого, чем получить тормоза в критический момент. По мере накопления опыта политики можно ужесточать.
Обязательно мониторьте эффективность. Экономия места - половина картины. Вторая половина - количество промахов, то есть ситуаций, когда нужные данные оказались на медленном уровне. Если промахов много, политики нужно корректировать.
Tiering хранения данных - рабочий инструмент оптимизации, а не обязательный этап развития инфраструктуры. При правильном внедрении он даёт существенную экономию без потери производительности. Но правильное внедрение начинается с честного ответа на вопрос, много ли у вас холодных данных. Если немного - купите SSD на весь объём и займитесь более полезными вещами.
Считаете конфигурацию хранилища под свои объёмы?
Инженеры ITTELO помогут разложить данные по уровням до закупки: посчитаем, сколько у вас реально горячих данных, подберём соотношение NVMe, SSD и HDD под нагрузку и бюджет, соберём и протестируем систему под задачу перед отгрузкой, с гарантией и поддержкой после продажи. На рынке серверов 11+ лет, и чаще всего экономия обнаруживается ещё на этапе расчёта - до того, как что-то куплено.


