
Эксперты в подборе IT-оборудования
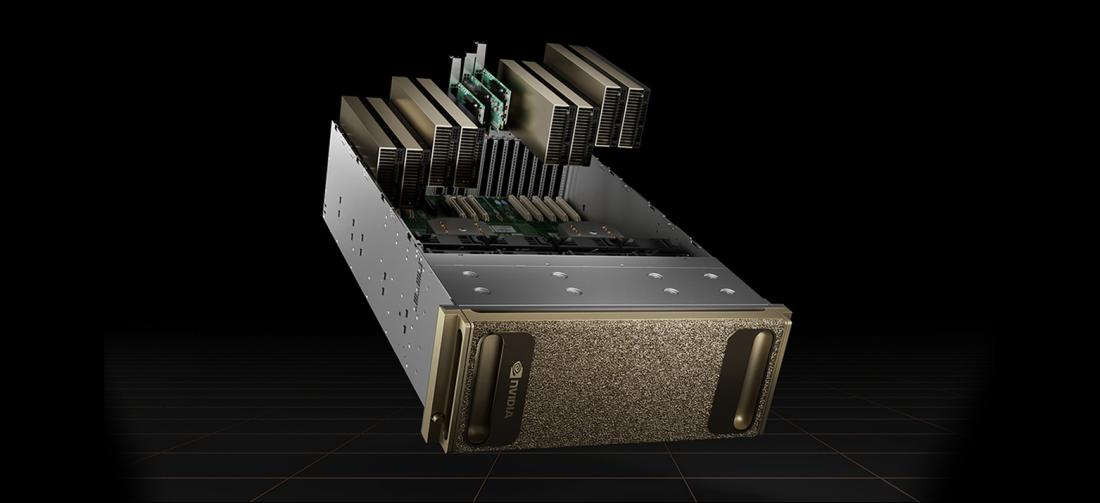
Давайте разберемся, почему GPU-серверы стали стандартом в индустрии машинного обучения, какие решения существуют на рынке и как выбрать оптимальную конфигурацию под ваши задачи. Если нужен готовый GPU-сервер для машинного обучения — можно сразу перейти в каталог, а здесь мы разберём, на что смотреть при выборе.
Прежде чем говорить о серверах, давайте выясним, почему графические процессоры так хороши для задач искусственного интеллекта. Дело в архитектуре — CPU создан для последовательного выполнения разнообразных задач, а GPU — для параллельного выполнения множества однотипных операций. Если сам термин требует пояснения, вот разбор, что такое глубокое обучение и чем оно отличается от классического машинного.
Нейросети — это в первую очередь матричные вычисления. Много-много матричных вычислений. И вот тут GPU показывает себя во всей красе. Представьте, что вам нужно перемножить две матрицы размером 1000×1000. CPU будет делать это последовательно, а GPU — одновременно по всему фронту.
Вот наглядное сравнение производительности для типичных задач машинного обучения:
| Параметр | CPU (Intel Xeon) | GPU (NVIDIA A100) | Преимущество GPU |
|---|---|---|---|
| Производительность (FP32) | ~2 TFLOPS | ~19.5 TFLOPS | ~10x |
| Параллельные вычисления | Ограничены (десятки ядер) | Масштабируемы (тысячи ядер) | ~100x |
| Энергоэффективность | Средняя | Высокая | ~4x |
| Обучение ResNet-50 | ~24 часа | ~2 часа | ~12x |
Разница колоссальная. И это только один GPU против одного CPU. А теперь представьте сервер с восемью A100 — это уже космические скорости.
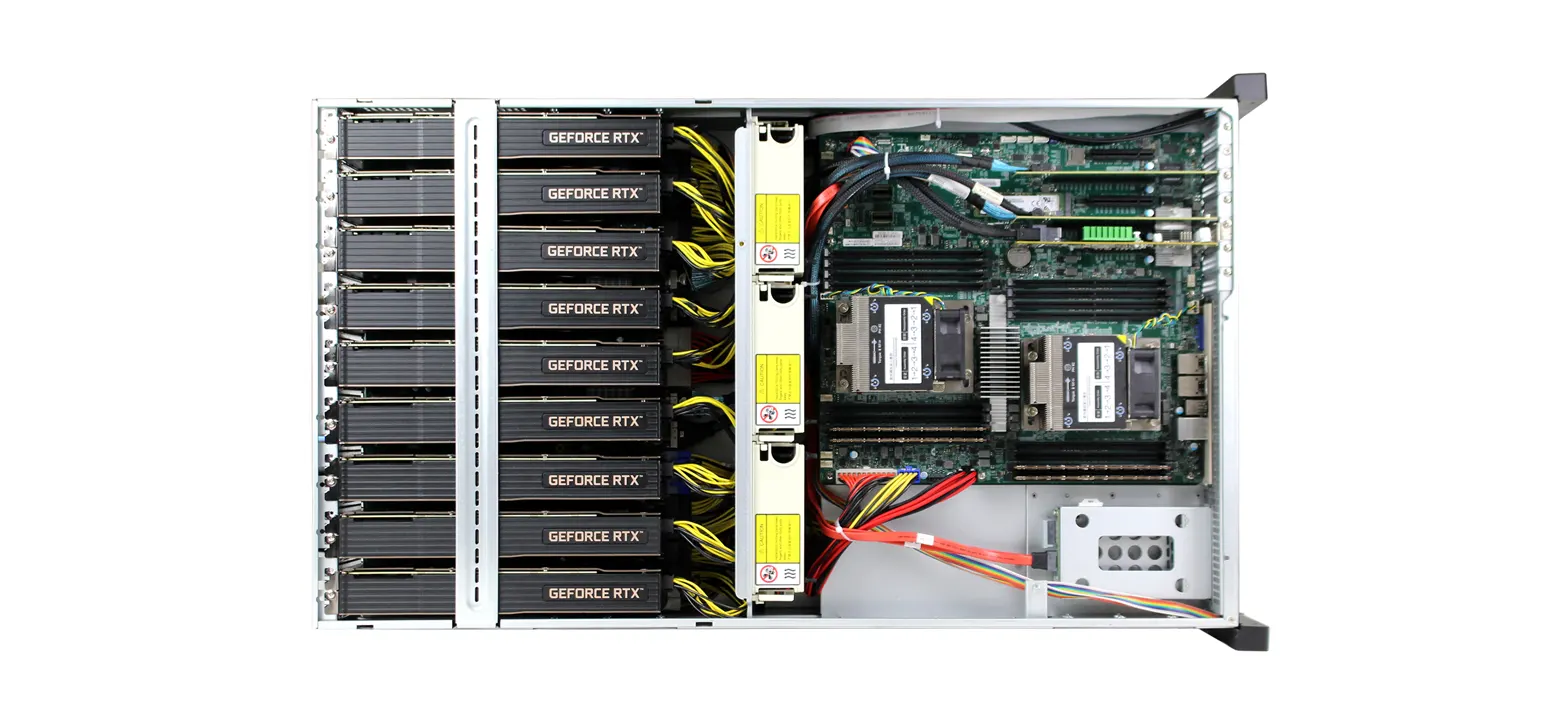
GPU-сервер для машинного обучения — это не просто обычный сервер с добавленными видеокартами. Это тщательно сбалансированная система, где каждый компонент подобран для максимальной производительности всего комплекса. Если речь не о кластере, а о паре рабочих мест, хватит и одной карты: как её подобрать, разобрано в статье «видеокарта для офиса и локального ИИ».
Вот ключевые элементы, на которые стоит обратить внимание:
Графический процессор — это главная звезда шоу. На рынке доминируют решения NVIDIA серии RTX, Tesla (теперь серии A) и Quadro для профессиональных задач. AMD также предлагает интересные решения с линейкой Instinct, а Intel недавно выпустила свои GPU Arc для вычислений.
Для серьезных задач машинного обучения чаще всего используются:
CPU в ML-сервере играет роль координатора, который распределяет задачи и обрабатывает части рабочего процесса, не подходящие для GPU. Мощный процессор важен для:
Современные серверы часто комплектуются процессорами AMD EPYC или Intel Xeon последних поколений с большим количеством ядер и поддержкой высокоскоростной памяти. Подробнее о том, что выгоднее для бизнеса — Intel или AMD, мы разобрали в отдельном материале.
Машинное обучение требует огромных объемов памяти. Для эффективной работы нужно:
Задержка доступа к данным может стать узким местом всей системы, поэтому экономить на подсистеме хранения не стоит.
Представьте, у вас стоят 4 GPU, каждый с TDP 300-400 Вт. Это 1200-1600 Вт только на видеокарты! А ведь есть еще процессоры, память, накопители... Общее энергопотребление легко переваливает за 2 кВт. С картами поколения Blackwell цифры выросли ещё: четыре RTX 5090 - это 2,3 кВт только на них. Как считать питание и тепло под такую машину, разобрано в статье про конфигуратор GPU-сервера. Такое количество энергии превращается в тепло, которое нужно эффективно отводить.
Для серьезных GPU-серверов необходимы:
Когда дело доходит до конкретных конфигураций, существует множество подходов к построению GPU-серверов для ИИ. Если вы хотите разобраться в базовых принципах, рекомендуем статью о том, как выбрать и собрать сервер для ИИ под реальные задачи.
Высокоплотные GPU-серверы максимизируют количество графических процессоров в ограниченном пространства стойки. Типичные особенности:
Эти монстры идеальны для обучения масштабных моделей, но требуют серьезных вложений и специальной инфраструктуры.
Не всем нужна ракета для полета на дачу. Модульные системы позволяют начать с малого и расширяться по мере необходимости:
Это хороший баланс между производительностью и сложностью для команд среднего размера.
Иногда разумнее комбинировать локальные вычисления с облачными: