Эксперты в подборе IT-оборудования
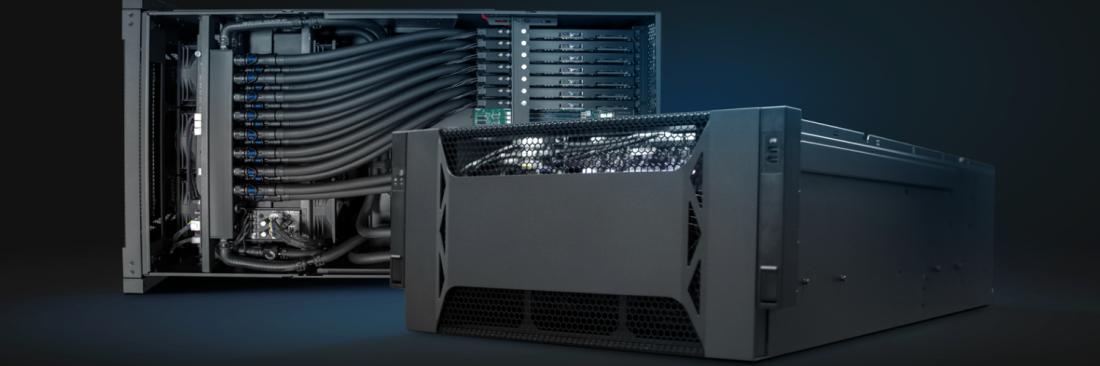
Если ваша нейросеть обучается неделями, а рендер сцены в Blender занимает сутки, пора задуматься о сервере с GPU. Но это не «взять помощнее видеокарту и воткнуть в корпус». GPU-сервер - сбалансированная система, где каждый компонент работает на одну задачу: максимальную скорость параллельных вычислений. Частный случай такой сборки - сервер под локальную LLM: под инференс языковой модели требования свои, разбираем в отдельной статье.
Разберёмся, из чего собирается такая машина и почему нельзя просто купить самый дорогой GPU и ждать чудес. Если конфигурация нужна прямо сейчас, а не в теории, у нас есть конфигуратор сервера - там можно собрать платформу и посмотреть, что с чем сочетается.
Обычный сервер рассчитан на последовательную обработку задач. Процессор отлично справляется с логикой, базами данных, веб-приложениями. Но когда речь заходит о матричных операциях - обучении нейросетей, рендеринге 3D-сцен, анализе терабайтов данных, - он упирается в предел. У него 64, может 128 ядер. У GPU - тысячи потоковых процессоров, и они устроены проще, зато считают одно и то же над разными данными одновременно. Подробнее о том, чем GPU отличается от CPU, у нас есть отдельный разбор.
Сервер для ИИ требует иного подхода. Здесь мощность видеокарт - лишь одна из величин. Рядом стоят пропускная способность шины PCIe, объём оперативной памяти и скорость обмена данными между процессором и картой. Если материнская плата не поддерживает PCIe 4.0 или 5.0, дорогие карты будут простаивать в ожидании данных. Если блок питания выдаёт 1500 Вт, а карты берут по 500-600 Вт каждая, система просто не запустится.
Всё упирается в баланс. Мощный GPU при слабом процессоре упрётся в подготовку данных. Избыток оперативки при недостатке видеопамяти заставит модель выгружаться на диск. Плохое охлаждение заставит карты сбрасывать частоты.
Рынок ускорителей для ИИ и рендеринга - почти монополия NVIDIA, и держится она на CUDA больше, чем на самих чипах. Библиотеки, фреймворки и готовые примеры пишут под неё, конкурентам остаётся догонять.
Второе, что нужно понимать в 2026 году: актуальное поколение NVIDIA называется Blackwell. H100 и H200 - это Hopper, поколение до него, A100 - Ampere, ещё на шаг раньше. Обе линейки живы, продаются и стоят в тысячах инсталляций, но называть H100 флагманом уже нельзя.
| Ускоритель | Поколение | Память | Потребление | Под что берут |
|---|---|---|---|---|
| RTX 5090 | Blackwell | 32 ГБ GDDR7 | 575 Вт | Инференс, рендер, бюджетные сборки. Без ECC и без NVLink |
| RTX PRO 6000 Blackwell | Blackwell | 96 ГБ | 600 Вт (есть версия Max-Q на 300 Вт) | Профессиональные станции и tower-серверы. Есть ECC |
| A100 | Ampere | 40 или 80 ГБ HBM2e | 250-400 Вт | Бюджетный вход в обучение, вторичный рынок |
| H100 | Hopper | 80 ГБ HBM3 | 350-700 Вт | Обучение и инференс среднего масштаба, поддержка FP8 |
| B200 | Blackwell | 180-192 ГБ HBM3e | ~1000 Вт | Текущее поколение для ЦОД, поставляется 8-GPU платами HGX |
| B300 / GB300 «Blackwell Ultra» | Blackwell Ultra | 288 ГБ HBM3e | до 1400 Вт | Фронтир, отгрузки со второй половины 2025 |
| AMD Instinct MI300X / MI325X | CDNA 3 | 192 ГБ HBM3 / 256 ГБ HBM3e | 750-1000 Вт | Альтернатива на ROCm, когда экосистема устраивает |
Есть ещё стоечные комплексы вроде GB200 NVL72, где 72 карты и 36 процессоров Grace связаны в одну систему на уровне стойки. Это другая лига и другой бюджет: такие вещи не собирают, их закупают целиком вместе с инженерным проектом. Дальше речь о том, что реально собрать самому.
Практический нюанс, который меняет всю логику сборки. Ни RTX 5090, ни RTX PRO 6000 Blackwell не поддерживают NVLink - прямую шину между картами. Общаются они через PCIe, и это заметно медленнее. Пока модель помещается в память одной карты, разницы нет. Как только она перестаёт помещаться и веса приходится делить между картами, шина становится узким местом. Отсюда правило: для сборки своими руками одна карта с большим объёмом памяти обычно лучше двух с маленьким. 96 ГБ на одной RTX PRO 6000 закроют задачи, на которых две 5090 по 32 ГБ будут упираться в обмен данными.
Про AMD: Instinct - серьёзное железо, а по объёму памяти на карту AMD местами обгоняет NVIDIA. Проблема прежняя - экосистема ROCm менее зрелая, чем CUDA, и часть библиотек не заводится из коробки. Брать имеет смысл, если вы понимаете, на чём именно будете считать, и готовы к возне с окружением.
Про Intel: дискретные Arc - потребительские карты, для GPU-сервера они не вариант. Серверная ставка Intel - ускорители Gaudi, и доступность их у нас ограничена.
Какую брать? Если коротко: обучение и тонкая настройка больших моделей - H100 или B200, инференс и рендер - RTX PRO 6000 Blackwell или 5090, вход с ограниченным бюджетом - A100 на вторичном рынке. Мы разбирали и бюджетную сборку на двух RTX 4090 с тестом DeepSeek 70B, и tower-сервер на двух RTX PRO 4000 Blackwell - там видно, как эти рассуждения выглядят на живом железе.
GPU - звезда шоу, но без правильного окружения она бесполезна. Пройдёмся по остальным частям сборки.
Материнская плата. Нужна поддержка нескольких слотов PCIe x16 версии 4.0 или 5.0. Платформы на AMD Threadripper Pro или на серверных Xeon - основной выбор. Убедитесь, что BIOS умеет делить линии PCIe между слотами, и проверьте физику: если планируете четыре карты, посмотрите, не перекрывают ли они друг друга и хватает ли расстояния между слотами.
Процессор. Самый мощный не обязателен, но ядер должно хватать на подготовку данных. Для четырёх-восьми карт достаточно 32-64 ядер. Гораздо важнее число линий PCIe: именно оно определяет, сколько карт вы физически подключите на полной скорости. У Intel актуальная линейка - Xeon 6 (индексы вида 6500P, 6700P), схема Bronze/Silver/Gold/Platinum осталась в прошлом поколении. У AMD под такие задачи берут Threadripper Pro или EPYC.
Оперативная память. Ориентир - от 256 ГБ для серьёзных задач, лучше 512 ГБ. Частота не критична, ECC важнее. При обучении данные сначала попадают в оперативную память и уже оттуда уходят на карту; если её мало, придётся читать с диска, а это на порядки медленнее.
Блок питания. Считайте суммарное потребление всех компонентов и закладывайте запас 20-30%. Это тот компонент, где экономия видна сразу: блоки без запаса работают на пределе, греются и стареют быстрее. Для многокарточных сборок обычно берут либо один блок серверного класса, либо два с синхронизацией.
Охлаждение. Карты серверного исполнения (пассивные, вроде A100 PCIe) рассчитаны на продув корпусом и без него перегреются. Карты с собственными вентиляторами проще в установке, но занимают больше места и шумят. При плотной установке карты греют друг друга - разносите их через слот или используйте райзеры. Если воздуха перестаёт хватать, следующий шаг - жидкостное охлаждение процессоров и GPU.
Накопители. NVMe SSD на 2-4 ТБ под систему и датасеты. Если работаете с большими архивами, добавьте сетевое хранилище с подключением от 10 Гбит/с. Скорость подачи данных на карту часто и оказывается узким местом.
Про это в статьях о сборке пишут реже всего, а спотыкаются о него первым.
Посчитаем простую конфигурацию: четыре RTX 5090 по 575 Вт - это 2 300 Вт только на карты. Добавьте процессор, память, диски и вентиляторы - получится около 3 кВт под нагрузкой. Обычная офисная розетка на 16 ампер при 230 вольтах даёт теоретический потолок 3,6 кВт, и это без запаса и без учёта того, что на той же линии обычно висит что-то ещё.
Дальше начинается арифметика помещения. Стойка в серверной небольшой компании чаще всего рассчитана на 3-5 кВт - под такую нагрузку считались и питание, и кондиционер. Один GPU-сервер съедает её целиком. Восемь карт в одной машине - это уже 5-6 кВт и отдельная силовая линия, а тепло от них нужно куда-то девать: сервер отдаёт в помещение почти всё, что потребил. До какой мощности стойку ещё можно охлаждать воздухом и что ставить дальше, разобрано в статье про предел воздушного охлаждения стойки.
Отсюда практические выводы:
Обучение нейросетей. Модель на несколько миллиардов параметров на процессоре будет считаться месяцами, на одной серверной карте - днями, на нескольких с быстрой связью между ними - ощутимо быстрее. Распараллеливание через PyTorch DDP делит батчи между картами.
3D-рендеринг. Blender Cycles, Octane, Redshift работают через CUDA. Сцена, которая на процессоре считается двое суток, на сборке из нескольких карт готова за часы. Для студий, работающих с анимацией и архвизом, разница решающая.
Генеративный ИИ. Локальные Stable Diffusion и подобные модели, тонкая настройка языковых моделей. Здесь важна не столько скорость, сколько объём видеопамяти: чем крупнее модель и выше разрешение, тем больше её нужно.
Аналитика больших данных. Apache Spark с RAPIDS, обработка данных через cuDF. Процессор справится, но GPU сделает это заметно быстрее.
Виртуализация GPU. Технология vGPU от NVIDIA делит одну карту между несколькими виртуальными машинами. Полезно, когда одним сервером пользуется несколько команд. Сколько именно пользователей потянет карта, зависит от профиля vGPU и задачи - универсального числа здесь нет.
Ориентировочные конфигурации под эти сценарии:
| Задача | Карты | Оперативная память | Питание |
|---|---|---|---|
| Инференс LLM, генерация изображений | 1 × RTX PRO 6000 Blackwell (96 ГБ) | 128-256 ГБ | от 1,2 кВт |
| Рендеринг, видео | 2-4 × RTX 5090 | 256 ГБ | от 3 кВт |
| Тонкая настройка моделей | 2 × H100 или A100 80 ГБ | 512 ГБ | от 2,5 кВт |
| Обучение с нуля | 4-8 × H100 / B200 | от 1 ТБ | от 5 кВт, отдельная линия |
Цифры ориентировочные и меняются вместе с задачей: та же модель в разной точности потребует разного объёма памяти.
Собрали сервер - не спешите пускать на реальные задачи. Сначала проверьте стабильность.
Нагрузочный тест карт. Прогоните gpu-burn или аналог, пусть карты поработают на полной нагрузке час-другой. Следите за температурой, потреблением и логами. Порог для большинства карт - 80-85 °C; если упираетесь в него на открытом стенде, в закрытом корпусе будет хуже.
Проверка связи между картами. Команда nvidia-smi topo -m покажет, как карты видят друг друга. Если у вас карты без NVLink, вы увидите, что весь обмен идёт через PCIe - это нормально, но полезно знать заранее, а не после первого распределённого запуска.
Синтетические тесты. MLPerf и подобные наборы дают сравнение с эталонными результатами для вашей конфигурации. Отставание на 20% - повод проверить, включён ли нужный режим PCIe и не стоит ли старый драйвер.
Реальная задача. Запустите обучение небольшой модели на стандартном датасете и замерьте время эпохи и утилизацию карт. Если карта загружена на 40%, узкое место не в ней.
Если у вас уже есть стойка, мониторинг и оркестрация задач, GPU-сервер должен встроиться в эту картину.
Мониторинг. Данные nvidia-smi собираются в Prometheus и выводятся в Grafana. Отслеживайте температуру, утилизацию, память и сброс частот. Простой дорогого железа из-за перегрева обходится дороже настройки алертов.
Управление задачами. Когда сервером пользуется несколько человек, нужен менеджер очередей - Slurm, Kubernetes с планированием по GPU или Ray. Иначе две задачи встанут на одну карту и обе будут считаться вдвое дольше.
Драйверы и библиотеки. Держите CUDA, cuDNN и NCCL в согласованных версиях, но не обновляйте драйверы на рабочем сервере без проверки на тестовом. Новый драйвер регулярно ломает совместимость с уже работающим кодом.
Энергоэффективность. Режим nvidia-smi -pm 1 снижает задержки при запуске задач. Если максимальная производительность круглосуточно не нужна, ограничьте потребление карт: снижение лимита на четверть обычно стоит существенно меньшей потери скорости, а по счетам за электричество и по нагрузке на кондиционер разница заметная.
Отдельный разговор, без которого статья про сборку остаётся теоретической.
Официальных поставок NVIDIA в Россию нет. Серверные ускорители приходят по альтернативным каналам, и меняется от этого организационная часть проекта, а не техническая. Что стоит заложить заранее:
Отсюда же практический совет по планированию: закладывайте на закупку и приёмку больше времени, чем на саму сборку. Собрать машину - несколько дней, довезти до неё карты - недели.
Что видно на горизонте ближайших лет.
Память растёт быстрее вычислений. Blackwell Ultra уже несёт 288 ГБ на карту, следующий шаг - переход на HBM4. Для практики это значит, что модели, которые сегодня приходится делить между картами, завтра поместятся в одну, и вся возня с распределённым обучением станет не нужна там, где сегодня без неё никак.
Потребление растёт вместе с памятью. 1000-1400 Вт на ускоритель - это новая норма верхнего сегмента. Воздушное охлаждение на таких мощностях подходит к пределу, и жидкостное из экзотики превращается в обычную опцию.
Инференс обгоняет обучение. Обучают модели немногие, запускают - все. Спрос смещается от машин для тренировки к машинам для работы уже готовых моделей, а у них другой профиль: важнее объём памяти и стоимость запроса, чем пиковая скорость.
У конкурентов NVIDIA дела идут неровно. Intel отменил Falcon Shores как коммерческий продукт и перенёс усилия на Jaguar Shores. AMD последовательно наращивает линейку Instinct, и по объёму памяти местами опережает NVIDIA, но экосистема ROCm пока догоняет CUDA. Специализированные ускорители - TPU у Google, Trainium у AWS - остаются в основном внутри облаков их создателей.
Сборка GPU-сервера - это проектирование системы под конкретную задачу, а не покупка самого дорогого ускорителя. Считайте память под вашу модель, питание под вашу серверную и сроки под вашу закупку. Тестируйте до продакшна. И помните, что узкое место чаще оказывается не в карте: в подготовке данных, в шине или в розетке.
Как подойти к выбору с другой стороны - от задачи, а не от железа, - в разборе как выбрать и собрать сервер для ИИ. Что бывает, когда две карты не хотят уживаться в одном корпусе, показано в заметке про конфликт при сборке на двух RTX 3090. Если интересен корпус под четыре карты - есть обзор Supermicro 741GE-TNRT.
Собираете машину под ИИ или рендеринг?
Инженеры ITTELO помогут посчитать память под вашу модель и питание под вашу серверную, подберут карты и платформу под задачу и бюджет, соберут и протестируют сервер под нагрузкой перед отгрузкой, с гарантией и поддержкой после продажи. На рынке серверов 11+ лет.
Сервер для обучения ИИ · +7 (800) 551-80-12 · info@ittelo.ru