
Эксперты в подборе IT-оборудования
52 минуты в год. Именно столько простоя допускает уровень 99.99% - то, что принято считать «нормальным» для серьёзной инфраструктуры. Звучит немного? До первого инцидента в пятницу вечером, когда упал платёжный шлюз и служба поддержки уже принимает звонки от агрессивных клиентов.
Но прежде чем говорить о том, как эти минуты не тратить, нужно разобраться с терминологией - потому что «кластер» и «HA-кластер» в большинстве разговоров используются как синонимы, хотя это два принципиально разных понятия.
HA-кластер - это группа серверов, которая продолжает обслуживать запросы при отказе любого из узлов. Три факта, которые из этого следуют:
Классический кластер решает другую задачу - это горизонтальное масштабирование. Вы добавляете узлы, чтобы обслуживать больше запросов: тысячи пользователей, параллельные вычисления, распределённые базы данных. Главная цель - производительность. Если нужен разбор кластеризации вообще, без привязки к отказоустойчивости, у нас есть отдельная статья про то, что такое кластер серверов.
HA-кластер (отказоустойчивый кластер) целится не в «выдержать нагрузку», а в «не упасть». Репликация состояния, автоматический failover, мониторинг живости узлов - всё это про то, чтобы при отказе одного сервера система продолжала работать без вмешательства человека.
Часто эти подходы комбинируют: балансировка нагрузки через HAProxy или DNS round-robin распределяет трафик по нескольким активным узлам, а под капотом работает HA-механизм, который следит за тем, чтобы ни один узел не выпал незаметно. Такая конфигурация даёт и запас по нагрузке, и гарантии доступности - но и настраивать её сложнее, чем каждую часть по отдельности.
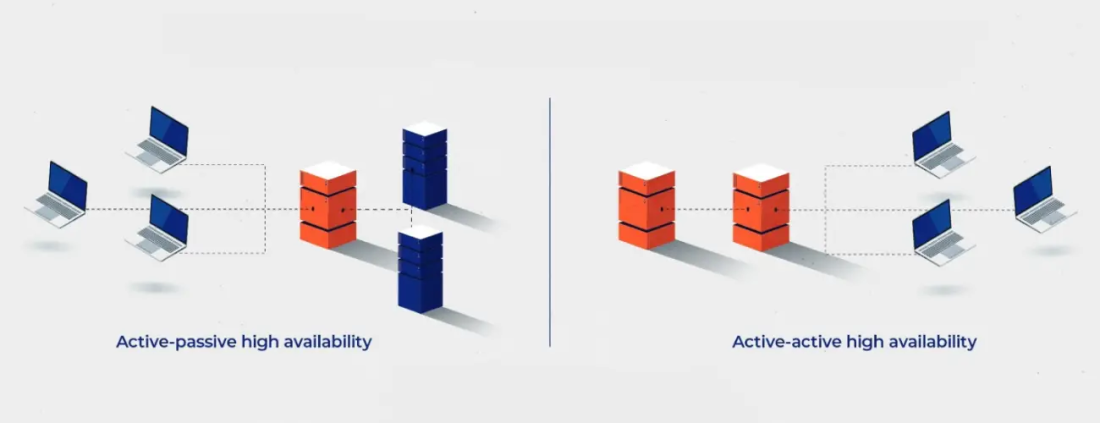
Два фундаментальных подхода к построению ha cluster, и у каждого своя цена и своя логика. Выбор между ними - вопрос не столько технический, сколько бизнесовый: что для вас дороже, простаивающее железо или риск просесть по производительности в момент пиковой нагрузки.
| Параметр | Active-Passive | Active-Active |
|---|---|---|
| Использование ресурсов | Резервный узел простаивает | Все узлы под нагрузкой |
| Сложность настройки | Ниже | Выше (нужна синхронизация состояния) |
| Время failover | 1-10 сек | Почти мгновенно (нет переключения) |
| Типичный стек | Pacemaker + Corosync | HAProxy + Keepalived, Kubernetes |
| Стоимость | Платите за железо, которое «спит» | Эффективнее по железу |
Active-passive проще в реализации и надёжнее в предсказуемости: основной узел работает, резервный - ждёт. При падении основного Pacemaker поднимает сервисы на резервном за считанные секунды. Это классика для баз данных - PostgreSQL + Patroni, MySQL + MHA.
Active-active сложнее: все узлы одновременно принимают трафик, и вам нужно решить вопрос конфликтов записи, если речь о БД. Зато при отказе одного узла остальные просто берут его долю нагрузки - никакого «тёплого старта».
На практике под «режимом работы кластера» понимают три разных состояния, и путать их дорого.
| Режим | Что происходит | Что делать |
|---|---|---|
| Штатный | Все узлы живы, кворум есть, ресурсы распределены по правилам | Ничего, только следить за heartbeat |
| Деградации | Узел выпал, сервисы переехали, кластер работает - но запаса больше нет | Чинить немедленно: следующий отказ станет фатальным |
| Обслуживания (maintenance) | Переводят вручную перед обновлением узла | Включать до работ, иначе Pacemaker примет плановую остановку за аварию |
Самое опасное здесь - режим деградации: система выглядит рабочей, мониторинг зелёный по внешним признакам, а второго шанса уже нет. Алерт нужен именно на переход в это состояние, а не на момент самого failover - тот как раз отрабатывает штатно.
Отдельный сценарий - split-brain, когда узлы потеряли связь и каждый считает себя основным. Это не режим, а авария, и от неё защищают кворум и fencing (см. ниже).
Heartbeat - это пульс кластера. Узлы постоянно обмениваются сигналами: «я живой, я живой, я живой». Если сигнал пропадает дольше заданного таймаута - запускается процедура failover. В Corosync этот механизм реализован через кольцевой протокол Totem, который умеет переживать потерю одного из каналов связи.
Shared storage - общее хранилище данных, к которому получают доступ все узлы кластера. Ceph даёт распределённое блочное хранилище с репликацией на уровне объектов, GlusterFS проще в развёртывании и хорошо работает для файловых хранилищ. Без этого компонента active-passive кластер либо бесполезен, либо превращается в дорогую игрушку.
Fencing (STONITH) - самый недооценённый компонент, который спасает от split-brain. Представьте: два узла потеряли связь друг с другом, но оба считают себя основными. Оба начинают писать в shared storage. Данные повреждены. STONITH (Shoot The Other Node In The Head) решает это радикально - изолирует «сомневающийся» узел через IPMI, iDRAC или аппаратный PDU, физически отключая его от питания или сети. Жёстко, но работает.
HA-кластер переключается на резервный узел за 1-10 секунд - быстрее, чем дежурный администратор успевает увидеть алерт в телефоне.
Вопрос всплывает постоянно, и путаница стоит дорого, потому что инструменты решают разные задачи.
Keepalived не переносит ресурсы. Он реализует протокол VRRP и умеет ровно одно: держать виртуальный IP-адрес и перекидывать его на резервный узел, когда основной перестаёт отвечать. Это один демон, минимум настройки, отличный выбор перед балансировщиком - HAProxy или nginx получают плавающий IP, и клиент не замечает переключения.
Pacemaker управляет ресурсами. Для него виртуальный IP - лишь один из типов ресурса наравне с сервисом, файловой системой, монтированием тома. Он знает зависимости между ними, порядок запуска и остановки, умеет ограничения размещения и вызывает fencing. Цена - связка из двух компонентов (Corosync плюс Pacemaker), агенты ресурсов и заметно более высокий порог входа.
Практический вывод простой. Нужен только плавающий IP перед парой балансировщиков - берите Keepalived, Pacemaker здесь избыточен. Нужно поднимать на резервном узле стек сервисов в правильном порядке (СУБД, потом приложение, потом IP) - это задача Pacemaker. И довольно часто их ставят вместе: Pacemaker держит прикладной кластер, Keepalived - плавающий IP на фронте.
Красивый SLA в договоре - это одно. Реальное понимание метрик - другое. Когда в договоре появляется «99.99% аптайма», редко кто из подписывающих представляет, что конкретно эта цифра означает для инфраструктуры и что будет, если её не выдержать.
Начнём с самого простого - сколько простоя прячется за каждой девяткой:
| Уровень | Простой в год | В месяц | В неделю |
|---|---|---|---|
| 99,9% («три девятки») | 8 ч 46 мин | 43,8 мин | 10,1 мин |
| 99,95% | 4 ч 23 мин | 21,9 мин | 5,0 мин |
| 99,99% («четыре девятки») | 52,6 мин | 4,4 мин | 1,0 мин |
| 99,999% («пять девяток») | 5,3 мин | 26 сек | 6 сек |
Разница между 99,9% и 99,99% - это разница между «успели приехать и починить» и «должно переключиться само». Между 99,99% и 99,999% - между кластером в одной серверной и распределённой системой с резервной площадкой. Каждая девятка дорожает кратно, поэтому цифру выбирают под задачу, а не «побольше».
Теперь метрики, которыми это меряют.
MTBF (Mean Time Between Failures) - среднее время между отказами. Чем выше, тем лучше. Для серверного оборудования производители заявляют MTBF в 100 000+ часов, но реальная эксплуатация - другая история, особенно если речь о дисках под интенсивной нагрузкой.
MTTR (Mean Time To Recovery) - среднее время восстановления. Вот тут HA-кластер и показывает себя: Pacemaker в правильно настроенной конфигурации укладывается в MTTR менее 10 секунд. Для сравнения - ручное восстановление даже опытным администратором редко занимает меньше 15-30 минут.
RTO и RPO - метрики для бизнеса, которые нужно обсуждать до настройки кластера, а не после первого инцидента. RTO (Recovery Time Objective) - сколько времени допустимо не работать. RPO (Recovery Point Objective) - сколько данных допустимо потерять. Для 99.99% RTO должен быть меньше минуты, RPO - в идеале нулевым (синхронная репликация) или близким к нулю. Синхронная репликация дороже асинхронной: она добавляет задержку к каждой записи, ожидая подтверждения от реплики, зато при failover потеря данных - ноль.
| Параметр | Цель для 99.99% | Инструмент |
|---|---|---|
| MTTR | < 10 секунд | Pacemaker |
| RTO | < 1 минуты | HAProxy |
| Минимум узлов | 3 (кворум) | Corosync |
| Простой в год | ≤ 52 минут | - |
| Простой в месяц | ≤ 4,4 минут | - |
Про кворум отдельно: почему минимум три узла? Два узла создают неразрешимую ситуацию при split-brain - каждый считает себя правым. Три узла дают возможность принять решение большинством голосов: 2 против 1, и кластер продолжает работу. Это же объясняет, почему etcd в Kubernetes и ZooKeeper в Kafka требуют нечётного числа узлов.
Если бюджет есть только на два узла, третий голос добавляют отдельно - арбитром. В Corosync это qdevice, в Proxmox VE - QDevice на любой третьей машине, в Windows Server - диск-свидетель или файловая шара. Полноценным узлом кластера арбитр не становится и нагрузку не несёт, его задача - разрешить спор при потере связи. Обходится это заметно дешевле третьего сервера, а от самого опасного сценария защищает.
Кворум работает строже, чем кажется: при потере связи между двумя узлами из трёх система не «зависает» - меньшинство изолируется, большинство продолжает обслуживать запросы.
На Linux основой большинства production HA-конфигураций остаётся связка Corosync + Pacemaker. Corosync обеспечивает групповую коммуникацию и кворум, Pacemaker управляет ресурсами кластера - знает, какие сервисы должны работать, где и в каком порядке запускаться при failover.
Для Proxmox VE HA встроен из коробки: в интерфейсе виртуальные машины назначаются HA-ресурсами, там же задаются приоритеты и политики failover. Под капотом - тот же Corosync, но без необходимости ковыряться в конфигах вручную. Для небольших команд это существенная экономия времени при первоначальной настройке. Если платформа виртуализации ещё не выбрана, перед настройкой HA стоит изучить полный разбор популярных гипервизоров.
Балансировка нагрузки через HAProxy или Nginx добавляется поверх HA-кластера для распределения входящего трафика. HAProxy работает на L4/L7, умеет health checks и автоматически исключает упавший бэкенд из ротации быстрее, чем пользователь замечает ошибку. Keepalived добавляет к этому виртуальный IP - при отказе основного балансировщика адрес мигрирует на резервный узел за доли секунды. Связка HAProxy + Keepalived - де-факто стандарт для высоконагруженных сервисов без бюджета на enterprise-балансировщик.
Мониторинг такой конфигурации собирается из трёх уровней:
| Уровень | Чем | Что смотреть |
|---|---|---|
| Узлы | Zabbix или Prometheus | CPU, RAM, дисковая латентность, сетевые интерфейсы. В Zabbix есть готовые шаблоны под Corosync и Pacemaker; в Prometheus базу закрывает node_exporter, состояние Kubernetes - kube-state-metrics |
| Сам кластер | crm_mon -1, метрики хранилища | Статус кворума, состояние ресурсов Pacemaker, задержка репликации. Для Ceph - ceph health, OSD latency, заполненность пулов: статус WARN даёт время отреагировать до CRITICAL |
| Оповещения | Alertmanager | Маршрутизация с учётом времени суток и ответственных. Без неё HA-инфраструктура превращается в генератор тревожных сообщений, которые все научились игнорировать |
Предиктивный анализ через ELK Stack связывает события между собой: если диск начинает давать ошибки SMART, а одновременно растёт латентность Ceph - это повод для превентивного обслуживания, а не для ночного аварийного восстановления. По настройке самого сбора метрик есть пошаговый разбор - мониторинг серверов на Zabbix.
Автоматизация развёртывания через Ansible снижает риск человеческой ошибки при настройке новых узлов и гарантирует идентичность конфигурации во всём кластере. Расхождение конфигураций - одна из частых причин «странного поведения» кластера через год после запуска: playbook на добавление узла выполняется воспроизводимо каждый раз, в отличие от ручной настройки по инструкции, которую последний раз обновляли полтора года назад.
Здесь решает не сравнение функциональности. Вопрос один: можно ли это купить и получить поддержку.
Red Hat прекратил продажи, услуги и партнёрские отношения в России и Беларуси в марте 2022 - RHEL High Availability Add-On с официальной подпиской и SLA сейчас недоступен. VMware после перехода к Broadcom официально в РФ не поставляется, и vSphere HA попадает в ту же категорию. Если эти стеки у вас уже развёрнуты, они продолжают работать, но планировать на них новые проекты - значит закладывать риск без поддержки и без легального пути обновления.
Открытый стек от поставок не зависит вовсе: Corosync с Pacemaker и Proxmox VE HA разворачиваются и обслуживаются самостоятельно. Для большинства on-premise сценариев этого достаточно, а коммерческая подписка Proxmox при необходимости покупается отдельно.
Если нужен реестр и сертификаты, вариантов три:
| Платформа | Основа | Что важно для HA | Сертификация |
|---|---|---|---|
| zVirt (Orion Soft) | KVM, управление унаследовано от oVirt | В версии 5.0 живая миграция ВМ между площадками без общей СХД. Штатного программно-определяемого хранилища внутри нет - под HCI берут продукт стороннего вендора, то есть два договора поддержки | Редакция zVirt Max - ФСТЭК, 4 уровень доверия, сертификат №4780 от 19.02.2024 до 19.02.2029; допуск в КИИ, ГИС, ИСПДн |
| ROSA Virtualization | oVirt/KVM, единый вендор на ОС, гипервизор и VDI | В версии 4.0 от 29.12.2025 появился встроенный Disaster Recovery - среди российских платформ это редкость | ФСТЭК, лицензирование по числу ВМ или по хостам |
| «Альт Виртуализация» (Базальт СПО) | Proxmox VE, пересобранный под ОС «Альт» | Вендор делает стабильные сборки и поддержку, а не переписывает функциональность - поведение предсказуемо тем, кто знает Proxmox | Идёт через ОС «Альт СП» с правом виртуализации. Формулировка в сертификате отличается от zVirt Max, и проверяющий смотрит именно на неё |
Выбор между ними для HA сводится к трём вопросам: нужен ли сертификат ФСТЭК и какой именно, нужен ли штатный DR из коробки, и готовы ли вы держать хранилище отдельным продуктом.
HA-кластер стоит денег - дополнительное железо, лицензии, время на настройку. Но посчитайте иначе.
Час простоя интернет-магазина с оборотом 5 млн рублей в день - это порядка 200 тысяч рублей недополученной выручки, если считать по среднему часу. Плюс репутационный ущерб, штрафы по SLA с партнёрами, стоимость работы команды на восстановление. Если HA-кластер предотвращает два таких инцидента в год, арифметика начинает складываться в его пользу.
Механика экономии простая и без ссылок на исследования. HA сокращает MTTR, потери от простоя прямо пропорциональны его длительности. Ручное восстановление - это 15-30 минут в лучшем случае, автоматический failover - секунды. Разница в стоимости инцидента получается в сотни раз, и она тем заметнее, чем дороже час простоя именно у вас.
Отдельный аргумент для финансового директора - страховая логика. HA-кластер работает как страховка: вы платите регулярный «взнос» в виде стоимости резервных узлов, чтобы не платить разово и непредсказуемо при каждом серьёзном сбое. Разница в том, что эта страховка ещё и добавляет запас производительности в штатном режиме.
Контейнерные рабочие нагрузки меняют правила игры. Kubernetes с правильно настроенными Deployment и PodDisruptionBudget даёт HA для приложений без отдельного уровня кластеризации серверов - планировщик сам перераспределяет поды при отказе узла. PodDisruptionBudget гарантирует, что при обновлении или дренировании узла одновременно не упадут все реплики: если у вас три пода и minAvailable=2, обновление пойдёт по одному поду за раз. Но это не отменяет необходимость HA для самого control plane: три мастер-узла, etcd с репликацией (etcd крайне чувствителен к дисковой латентности - ставьте его на NVMe), внешний балансировщик для kube-apiserver.
Geo-replication выводит отказоустойчивость на уровень катастрофоустойчивости. Синхронная репликация между дата-центрами в пределах одного города (задержка меньше 5 мс) даёт RPO близкий к нулю. Асинхронная между регионами - компромисс между RPO и стоимостью канала: задержка 50-100 мс означает, что при мгновенной катастрофе вы потеряете несколько секунд данных, но сервис поднимется в резервной локации по заранее отработанному плану.
Безопасность в HA-кластерах часто оказывается последним пунктом - и зря. Трафик между узлами нужно шифровать (TLS для Corosync, mTLS в Kubernetes через cert-manager или Istio), heartbeat-сеть изолировать в отдельный VLAN, а доступ к IPMI/iDRAC закрывать от production-сети - всё это базовые требования при подготовке серверной инфраструктуры к ИБ-аудиту. Если атакующий получает доступ к BMC-интерфейсу, он может выключить STONITH в нужный момент и устроить split-brain намеренно.
Для крупных инсталляций добавляется инженерная часть: при плотности 20-30 кВт на стойку воздушное охлаждение перестаёт справляться без серьёзных затрат на инфраструктуру серверного помещения, и в ход идут жидкостные решения. Для кластера из трёх-четырёх узлов в обычной серверной комнате это неактуально - там хватает грамотной организации потоков воздуха.
Группа серверов, которая продолжает обслуживать запросы при отказе любого из узлов: они следят за живостью друг друга, а сервисы упавшего автоматически поднимаются на оставшихся.
Обычный кластер решает задачу производительности - добавляет узлы, чтобы обработать больше запросов. HA-кластер решает задачу доступности - чтобы отказ узла не остановил сервис. На практике их часто совмещают.
Нет. Keepalived через VRRP переносит только виртуальный IP-адрес. Pacemaker управляет ресурсами целиком - сервисами, файловыми системами, порядком запуска и зависимостями между ними, а также вызывает fencing.
Минимум три - для кворума. С двумя узлами при потере связи каждый считает себя основным, и решить спор большинством голосов не получается. Если серверов только два, третий голос добавляют арбитром (qdevice в Corosync, QDevice в Proxmox VE, диск-свидетель в Windows Server) - он не несёт нагрузку и стоит дешевле полноценного узла.
52,6 минуты в год, 4,4 минуты в месяц, около минуты в неделю. Уровень 99,9% допускает уже 8 часов 46 минут в год.
В active-passive резервный узел ждёт и включается при отказе основного - проще и предсказуемее. В active-active нагрузку несут все узлы одновременно - эффективнее по железу, но требует решать конфликты записи.
Высокая доступность - это не конечное состояние, которое «настроили и забыли». Это дисциплина: регулярные тесты failover в боевой среде (да, намеренные), обновление узлов по rolling-стратегии без окна обслуживания, алерты на режим деградации, а не на одну аварию.
Кластер, который не тестировали в условиях реального сбоя, - это дорогое оборудование с иллюзией надёжности. Первый раз, когда failover отрабатывает по-настоящему, не должен быть сюрпризом.
Собираете отказоустойчивый кластер?
Инженеры ITTELO подберут узлы под нужный уровень доступности, соберут и протестируют конфигурацию под задачу перед отгрузкой, с гарантией и поддержкой после продажи. На рынке серверов 11+ лет.
Сервер для виртуализации · +7 (800) 551-80-12 · info@ittelo.ru


