Эксперты в подборе IT-оборудования

К нам обратился технический отдел российской компании, которая занимается электромонтажом, проектированием, построением структурированных кабельных сетей и системами автоматизации. Задача звучала так: собрать полноценную гиперконвергентную инфраструктуру из того оборудования, которое уже стоит в офисе, не закупая новое.
Ситуация была типичной для компании, которая росла постепенно. Серверы покупались под конкретные задачи по мере их появления, в основном это оказалось оборудование HP. Сами по себе машины работали и справлялись с хранением и обработкой корпоративных данных. Но единой сетевой подсистемы серверной фермы не было: получился набор отдельных узлов вместо инфраструктуры.
Требовалось объединить разрозненные кластеры в централизованную программно-определяемую систему, где хранилище, сеть и вычислительные ресурсы управляются из одного интерфейса. Поскольку парк был преимущественно HP, решили и дальше держаться этого вендора: так проще с совместимостью, запчастями и обслуживанием.
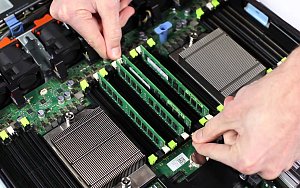
Первым шагом привели существующие серверы в соответствие с системными требованиями целевой архитектуры - без этого гиперконвергентное решение на них просто не встало бы. Это был комплексный апгрейд серверных модулей.
Часть работ команда заказчика выполняла своими силами, часть - вместе с нашими инженерами. Разворачивание гиперконвергентной платформы - не рядовая операция, которую делают каждый месяц, поэтому на этом этапе мы вели консультационную поддержку: помогали с проектированием целевой архитектуры и с развёртыванием.
За несколько месяцев работы:
Главный результат для заказчика был не в производительности как таковой. Компания получила инфраструктуру, которую можно расширять по мере роста и перестраивать под смену задач, не выбрасывая уже купленное железо. Программно-определяемое хранилище на имеющихся серверах дало запас по масштабированию без новой закупки.
Важная оговорка для тех, кто читает этот кейс сегодня. Проект строился на платформе VMware vSphere, а она официально в Россию больше не поставляется: вендор ушёл с рынка, после перехода к Broadcom ситуация не изменилась. Повторять эту схему на vSphere в новом проекте не получится - лицензии обычными путями не купить. Сама идея кейса от этого не устаревает: гиперконвергентную инфраструктуру сегодня собирают на российских платформах. Что именно доступно и чем они отличаются, разбирали в обзоре zVirt, ROSA и «Альт».
Кейс показателен одним: гиперконвергентную инфраструктуру не обязательно начинать с закупки. Если в парке уже есть несколько однотипных серверов приличного поколения, чаще всего дешевле довести их до требований платформы, чем менять всё разом. Апгрейд памяти, дисков и сетевых карт обходится в разы меньше новых узлов.
Работает это не всегда. Если машины разных поколений и вендоров, разной конфигурации или слишком старые для требований платформы, попытка собрать из них кластер выйдет дороже нормальной закупки и принесёт проблемы с поддержкой. Где проходит эта граница и в каких случаях гиперконвергенция вообще оправдана, разобрано в материале за и против гиперконвергентной инфраструктуры. Про сборку отказоустойчивого кластера с запасом по мощности и ёмкости есть отдельное руководство.
Думаете, можно ли собрать кластер из того, что уже стоит в стойке?
Инженеры ITTELO посмотрят на ваш парк и скажут прямо: где хватит апгрейда имеющихся машин, а где дешевле и надёжнее взять новые узлы. Подберём конфигурацию под нагрузку, соберём и протестируем под задачу перед отгрузкой, с гарантией и поддержкой после продажи. На рынке серверов 11+ лет.
Гиперконвергентная инфраструктура · +7 (800) 551-80-12 · info@ittelo.ru